Cập nhật: tháng 9/2026.
Hai câu này là kết quả dịch thật, lấy từ kho tài liệu của tôi:
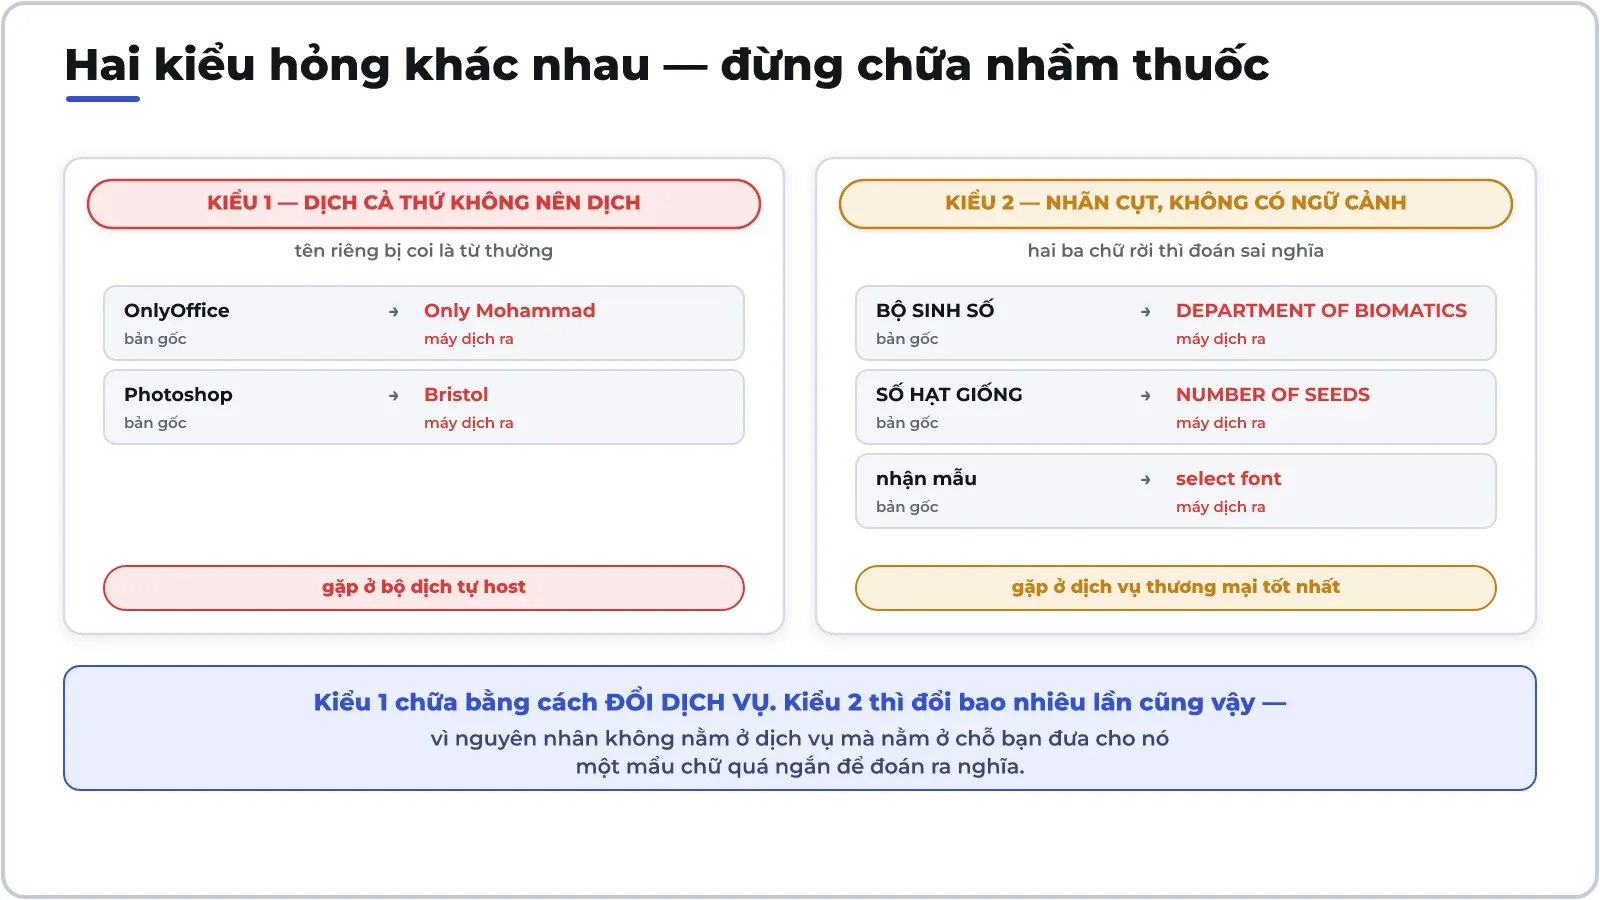
- OnlyOffice → “Only Mohammad”
- BỘ SINH SỐ → “DEPARTMENT OF BIOMATICS”
Cả hai đều là dịch máy. Nhưng chúng đến từ hai dịch vụ khác nhau, và quan trọng hơn: hai nguyên nhân khác hẳn nhau. Một cái chữa được bằng cách đổi dịch vụ. Cái kia thì đổi bao nhiêu lần cũng vậy.
Bài này là những gì tôi đo được sau khi dịch một kho hơn 230 bài kỹ thuật sang ba thứ tiếng — cái gì hỏng, vì sao hỏng, và cách chữa nào thật sự có tác dụng.
Hai kiểu hỏng, và đừng chữa nhầm thuốc
Kiểu một: máy dịch cả thứ không nên dịch. Bộ dịch tự host mà tôi thử đầu tiên chạy rất trôi chảy, nhưng nó coi tên riêng là từ thường. OnlyOffice thành “Only Mohammad”. Photoshop thành “Bristol”. Đây là lỗi chết người với tài liệu kỹ thuật, vì tên riêng chính là thứ người đọc tra lại — dịch sai tên phần mềm thì cả câu thành vô dụng.
Kiểu hai: máy không có đủ chữ để đoán nghĩa. Dịch vụ thương mại tốt nhất tôi dùng giữ tên riêng hoàn hảo, dịch văn xuôi mượt — nhưng gặp một cái nhãn hai ba chữ thì nó chế ra những thứ như “DEPARTMENT OF BIOMATICS”. Vài ca thật khác trong kho của tôi:
- “SỐ HẠT GIỐNG” → “NUMBER OF SEEDS” (số lượng hạt giống — trong khi ý là giá trị của hạt giống)
- “nhận mẫu” → “select font” (nó hiểu “mẫu” là mẫu chữ)
- “tiền huấn luyện” → chi phí đào tạo (nó hiểu “tiền” là tiền bạc, không phải tiền- như trong tiền tố)
- “token nạp vào” → 入金 trong tiếng Nhật, tức nộp tiền vào tài khoản
Nhìn danh sách đó thì thấy quy luật: máy không sai ngữ pháp, nó sai NGHĨA — và sai đúng ở những chỗ tiếng Việt có từ đồng âm mà chỉ ngữ cảnh mới phân biệt được. Mà nhãn hai ba chữ thì làm gì có ngữ cảnh.
Vì sao “bọc bảo vệ” tên riêng lại hỏng
Với kiểu hỏng thứ nhất, phản xạ tự nhiên là bảo vệ tên riêng trước khi đưa vào máy. Tôi đã thử hai cách, và cả hai đều hỏng — ghi lại đây để ai đó khỏi mất thời gian như tôi.
Cách 1 — thay tên riêng bằng mã giữ chỗ (kiểu XKEEP0X), dịch xong thì thay ngược lại. Kết quả: máy nuốt mất nửa câu. Cái mã giữ chỗ vô nghĩa với nó, nên nó xử lý phần còn lại như một câu cụt và tự ý cắt gọt.
Cách 2 — bọc tên riêng trong thẻ <code> để máy coi là mã lập trình và bỏ qua. Kết quả: tên riêng được giữ đúng, nhưng ngữ pháp quanh nó bị cắt vụn — câu đọc lên như bị gãy khúc.
Bài học chung của cả hai lần: can thiệp vào chuỗi đầu vào là can thiệp vào chính thứ mà máy dùng để đoán ngữ pháp. Bạn lấy đi một mẩu câu thì bạn cũng lấy đi manh mối mà nó cần để dựng lại câu ở đầu kia.
Cách chữa thật sự lại đơn giản đến mức hơi chán: đổi dịch vụ. Dịch vụ thương mại giữ tên riêng đúng ngay từ đầu, không cần bọc gì cả. Nói cách khác — chọn công cụ theo điểm yếu nào bạn không chịu nổi, chứ đừng chọn theo điểm mạnh nào nghe hay.
Câu thì trôi, nhãn thì gãy
Sau khi chuyển sang dịch vụ thương mại, tôi đo trên đúng bộ chữ nằm trong các sơ đồ minh hoạ, và quy luật hiện ra rất rõ:
- Câu hoàn chỉnh: dịch tốt. Những câu dài trong sơ đồ và toàn bộ văn xuôi của bài đều ra bản dịch đọc được, giữ đúng thuật ngữ, không phải sửa.
- Nhãn cụt hai ba chữ: hỏng thường xuyên. Nhất là nhãn VIẾT HOA, vì viết hoa còn lấy mất luôn manh mối về từ loại.
Điều này nghe hiển nhiên khi đã biết, nhưng nó lật ngược một thói quen phổ biến: người ta hay trích riêng các nhãn ra một tệp rồi đưa cả tệp cho máy dịch, vì làm vậy gọn. Chính cái gọn đó phá hỏng chất lượng — bạn vừa tước sạch ngữ cảnh của từng mẩu chữ.
Nếu buộc phải dịch nhãn rời, có hai đường: đưa kèm một câu ngữ cảnh, hoặc đừng để máy dịch chúng nữa.
Từ điển ghi đè: cách chữa rẻ nhất
Đường thứ hai là cái tôi đang dùng, và nó rẻ đến bất ngờ. Cơ chế chỉ có một câu: trước khi gọi máy dịch, tra một từ điển do người viết; có thì dùng luôn, không có thì mới gọi máy.
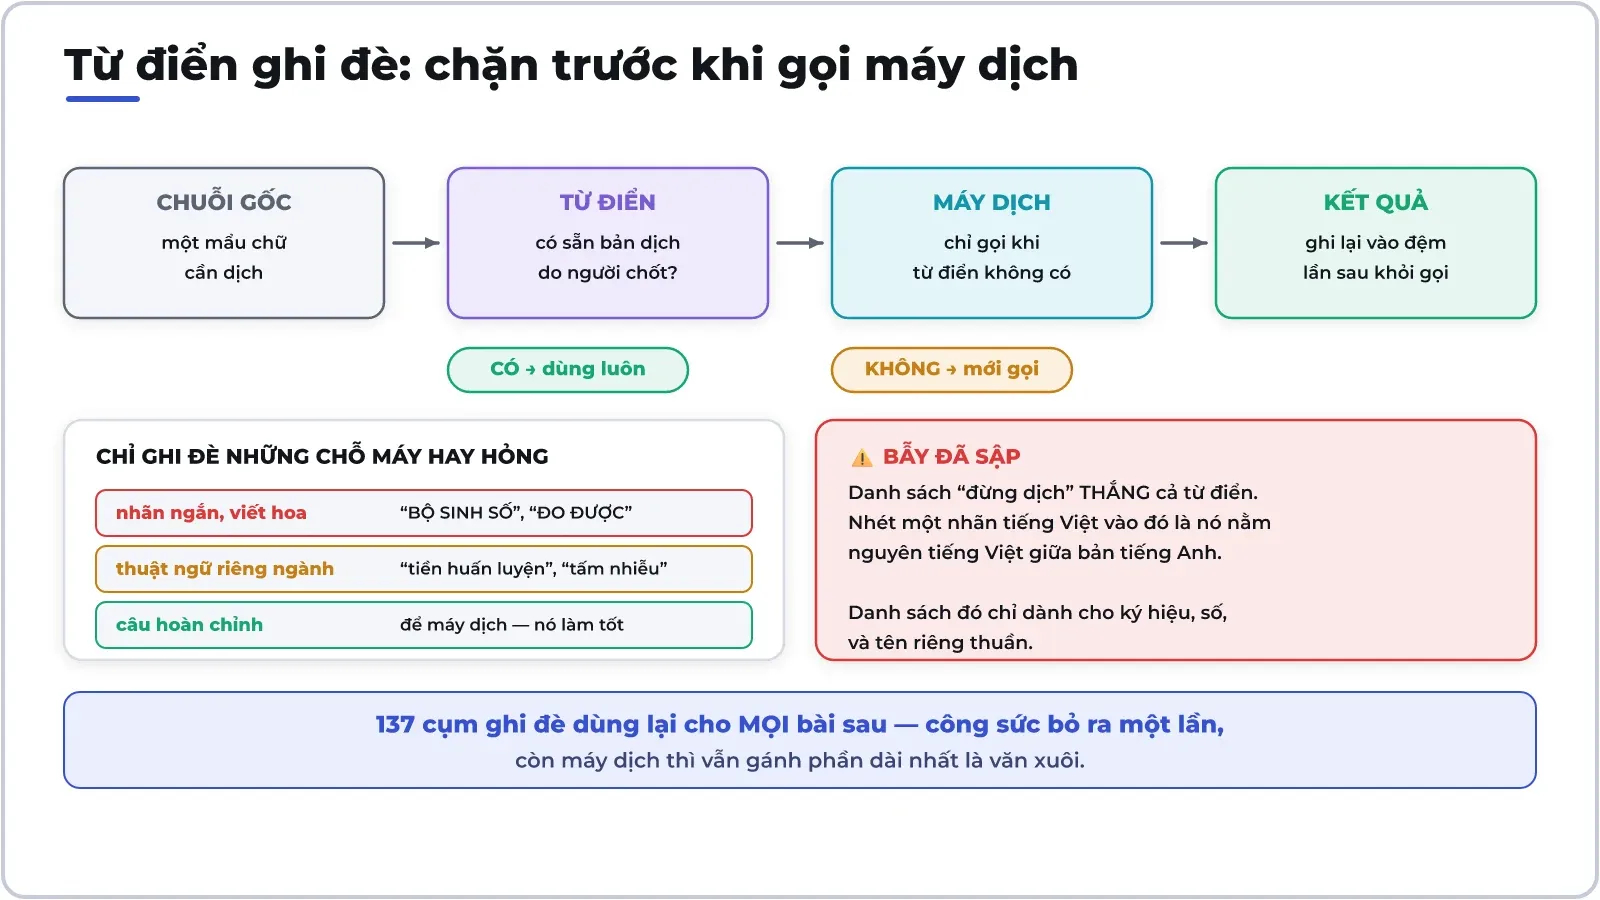
Điểm mấu chốt nằm ở chỗ bạn không cần dịch tay cả tài liệu — chỉ cần phủ đúng những chỗ máy hay hỏng. Hiện từ điển của tôi có 137 cụm, gần như toàn nhãn ngắn và thuật ngữ riêng ngành. Phần dài nhất, tức văn xuôi, vẫn để máy gánh. Và 137 cụm ấy dùng lại được cho mọi bài sau: công sức bỏ ra một lần, giá trị cộng dồn mãi.
Hầu hết dịch vụ thương mại nay có sẵn tính năng này dưới tên glossary — nhưng kể cả khi tự viết lấy, nó cũng chỉ là một bảng tra và một câu lệnh “nếu có thì dùng”.
Một cái bẫy đã sập, ghi lại để đừng ai sập nữa: nếu công cụ của bạn có thêm một danh sách “đừng dịch” (để giữ nguyên mã, ký hiệu, tên riêng), hãy kiểm xem danh sách đó có thắng cả từ điển không. Của tôi thì có. Tôi đã nhét một nhãn tiếng Việt vào danh sách “đừng dịch” cho chắc ăn — kết quả là nhãn đó nằm nguyên tiếng Việt giữa bản tiếng Anh. Danh sách “đừng dịch” chỉ nên chứa ký hiệu, con số và tên riêng thuần.
Chữ trong HÌNH mới là phần đắt
Nếu tài liệu của bạn có sơ đồ, biểu đồ, ảnh chụp màn hình có chú thích — phần đó tốn công hơn toàn bộ văn xuôi cộng lại. Không phải vì dịch khó, mà vì bản dịch nở ra còn cái khung thì không.
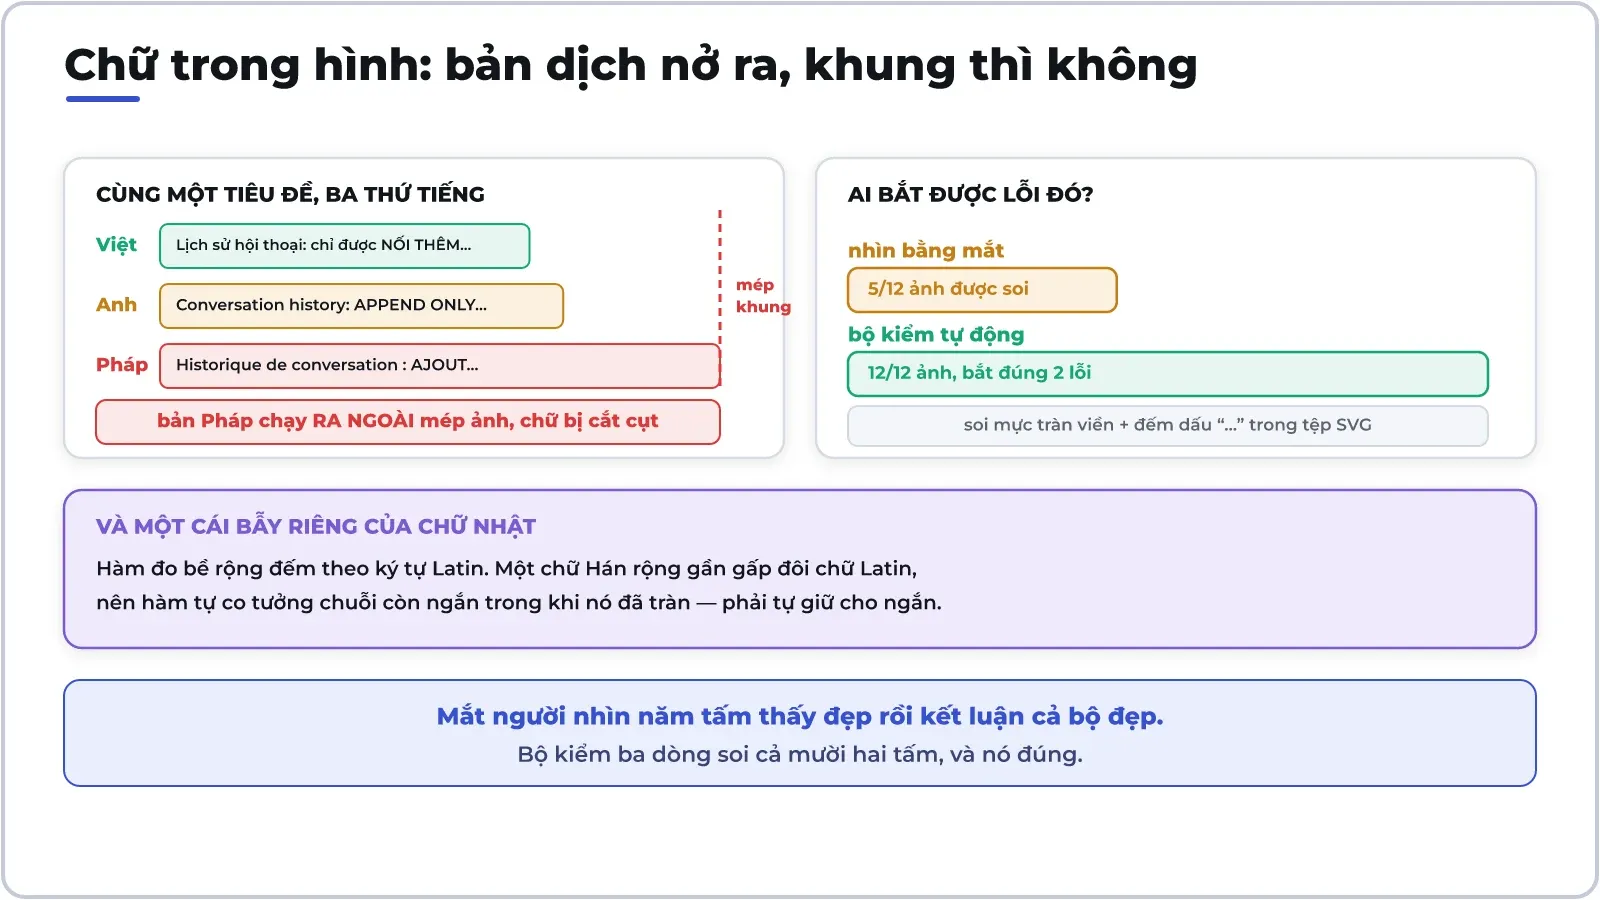
Đo trên chính bộ sơ đồ tôi vừa làm: cùng một tiêu đề, bản tiếng Anh dài hơn bản tiếng Việt khoảng một phần mười, bản tiếng Pháp dài hơn tới một phần ba. Cái tiêu đề tiếng Pháp ấy chạy thẳng ra ngoài mép ảnh và bị cắt cụt — trong khi bản Việt và Anh vừa khít.
Chữ Nhật lại có cái bẫy ngược. Nó ít ký tự hơn, nên mọi hàm ước lượng bề rộng theo số ký tự đều tưởng chuỗi còn ngắn — trong khi một chữ Hán rộng gần gấp đôi một chữ Latin. Hàm tự co cỡ chữ vì thế không co, và chữ tràn ra ngoài khung mà không ai báo.
Cách chữa gồm hai phần. Một: cho mọi nhãn tự co cỡ chữ khi vượt khung — sửa ở hàm dùng chung thì cả bộ tài liệu được hưởng. Hai, và đây mới là phần đáng nói: viết một bộ kiểm tự động.
Bộ kiểm của tôi vỏn vẹn ba dòng ý tưởng — soi xem có nét mực nào nằm ngoài viền khung không, và đếm xem tệp SVG có dấu “…” nào do hàm tự cắt sinh ra không. Kết quả: tôi đã nhìn bằng mắt 5 trong 12 tấm, thấy đẹp, và định đăng. Bộ kiểm chạy hết 12 tấm và bắt được 2 tấm hỏng nằm ngoài phần tôi đã nhìn.
Đây là bài học tôi giữ lại lâu nhất từ cả việc này: mắt người nhìn năm tấm thấy đẹp rồi kết luận cả bộ đẹp. Với tài liệu đa ngữ, ngôn ngữ bạn không đọc được chính là ngôn ngữ bạn kiểm hời hợt nhất.
Góc kinh tế: giá thật của chữ “miễn phí”
Ba lựa chọn, ba kiểu trả giá.
Bộ dịch tự host thì tiền dịch bằng không. Nhưng nó ăn RAM, ăn thời gian dựng, và — như đã đo ở trên — trả lại bằng chất lượng: mọi tên riêng đều phải rà tay. Với tài liệu kỹ thuật dày đặc tên sản phẩm, đó là công việc sửa nhiều hơn công việc dịch. Đây đúng là cái đánh đổi mà bài về tự host dịch vụ đã nói, chỉ là lần này hoá đơn được trả bằng thời gian rà chữ.
Gói miễn phí của dịch vụ thương mại thường cho khoảng một triệu ký tự mỗi tháng. Nghe trừu tượng, nên quy ra số thật từ kho của tôi: một bài dài chừng 2 600 từ, dịch sang ba thứ tiếng hết khoảng 40 nghìn ký tự — tức một tháng đăng được cỡ 25 bài mà không tốn đồng nào. Với một blog cá nhân thì đó là thừa; với một đội tài liệu sản phẩm thì hết trong một tuần.
Gói trả tiền thì tính theo ký tự, và đây là chỗ dễ tính sai nhất. Con số đáng so không phải giá mỗi triệu ký tự, mà là tổng của tiền dịch cộng thời gian sửa. Một dịch vụ đắt hơn trên hoá đơn nhưng giữ đúng tên riêng có thể rẻ hơn hẳn, vì nó xoá sạch một công đoạn rà tay. Cùng một lối tính với chi phí trên mỗi việc xong chứ không phải trên mỗi lượt gọi — xem thêm bài so sánh gói lưu trữ đám mây cho cùng kiểu bẫy giá niêm yết.
Và có một khoản tài sản ít ai tính: từ điển ghi đè là thứ tăng giá trị theo thời gian. 137 cụm hôm nay sẽ là 200 cụm sau vài tháng, và mỗi cụm được dùng lại ở mọi bài sau. Nó cũng là thứ duy nhất trong cả quy trình không phụ thuộc vào việc bạn đang dùng dịch vụ nào — đổi nhà cung cấp thì từ điển đi theo.
Nếu bạn định tự dựng bộ dịch của riêng mình, năm câu hỏi trước khi cài một phần mềm mã nguồn mở vẫn áp dụng nguyên vẹn — và câu quan trọng nhất ở đây là câu về chi phí bảo trì.
Dự đoán
- Từ điển ghi đè sẽ thành thứ bắt buộc, không còn là tính năng cao cấp. Khi mọi dịch vụ đều dịch văn xuôi tốt như nhau, chỗ còn phân biệt được chất lượng chính là thuật ngữ riêng của từng tổ chức.
- Dịch chữ trong hình sẽ được làm tự động từ đầu. Hôm nay ai cũng dịch văn bản trước rồi mới nhớ ra còn hình; công cụ nào gộp được hai việc — và tự co chữ cho vừa khung — sẽ ăn phần lớn nhu cầu tài liệu đa ngữ.
- Bộ kiểm tự động sẽ đi kèm quy trình dịch như bộ kiểm chính tả. Không phải để chấm chất lượng bản dịch, mà để bắt những lỗi cơ học: tràn khung, cắt cụt, sót chuỗi chưa dịch.
- Bộ dịch tự host vẫn có chỗ, nhưng là chỗ khác. Nơi dữ liệu không được rời khỏi máy — hồ sơ bệnh án, hợp đồng — thì chất lượng kém hơn vẫn là cái giá chấp nhận được. Còn với tài liệu công khai thì lý do dùng nó đang mỏng dần.
- Nhưng khâu người đọc lại sẽ không biến mất. Máy càng trôi chảy thì lỗi càng khó thấy: một câu sai nghĩa mà đúng ngữ pháp nguy hiểm hơn hẳn một câu gãy. Vẫn phải có người biết thứ tiếng đó đọc qua — và bộ kiểm tự động chỉ giúp họ khỏi phải soi những thứ máy soi được.
Thảo luận