Cập nhật: tháng 9/2026.
Ngày 1/9/2026, Anthropic công bố Claude Fable 5.1 và người anh em song sinh Claude Mythos 5.1. Bản tin thì nói về benchmark, nhưng có hai chi tiết đáng chú ý hơn nằm ở chỗ khác. Thứ nhất: giá mỗi token không đổi một xu — vẫn 10 đô cho một triệu token vào, 50 đô cho một triệu token ra — mà hãng vẫn tuyên bố hoá đơn giảm khoảng một phần tư. Thứ hai: bản ghi chú kỹ thuật của nó đầy những dòng bắt đầu bằng “trả về lỗi 400”.
Hai chi tiết đó nói nhiều về mô hình này hơn cả bảng điểm. Bài này đọc Fable 5.1 qua chính API của nó — vì mỗi thứ bị cấm đi là một quyết định thiết kế, và quyết định thiết kế thì thật thà hơn thông cáo báo chí.
Một mô hình, hai lớp bảo vệ
Điều đầu tiên cần gỡ rối: Fable 5.1 và Mythos 5.1 là cùng một mô hình. Theo chính Anthropic, chúng chỉ khác nhau ở mức độ rào chắn an toàn. Fable 5.1 phát hành rộng rãi; Mythos 5.1 chỉ đến tay người dùng qua chương trình truy cập tin cậy, với bộ rào chắn thiết kế riêng cho công việc an ninh mạng và khoa học sự sống.
Đây là một cách chia đáng để ý, và nó không phải chuyện kỹ thuật: hãng đang tách NĂNG LỰC khỏi QUYỀN. Cùng một bộ trọng số, ai được làm gì thì tuỳ vào việc bạn đã được xác minh hay chưa. Trước đây ranh giới đó nằm bên trong mô hình — mô hình mạnh thì kèm rào chắn chặt, và người dùng chính đáng chịu chung phần chặn nhầm với người dùng xấu. Nay ranh giới được đẩy ra ngoài, thành một câu hỏi về danh tính và hợp đồng.
Phần còn lại của bảng thông số: mã mô hình claude-fable-5-1, cửa sổ ngữ cảnh một triệu token (và mức tối đa cũng chính là mức mặc định), đầu ra tối đa 128 nghìn token, có mặt trên tất cả các nền tảng lớn gồm Amazon Web Services, Google Cloud và Microsoft Azure.
Đọc bảng số cho đúng
Anthropic công bố một loạt điểm số. Nhưng đọc kỹ thì chỉ có đúng MỘT phép đo được công bố kèm mốc so sánh cùng đời mô hình: Terminal-Bench-Science 0.1, nơi Fable 5.1 đạt 52,6% so với 24,7% của Fable 5 — gấp 2,1 lần.
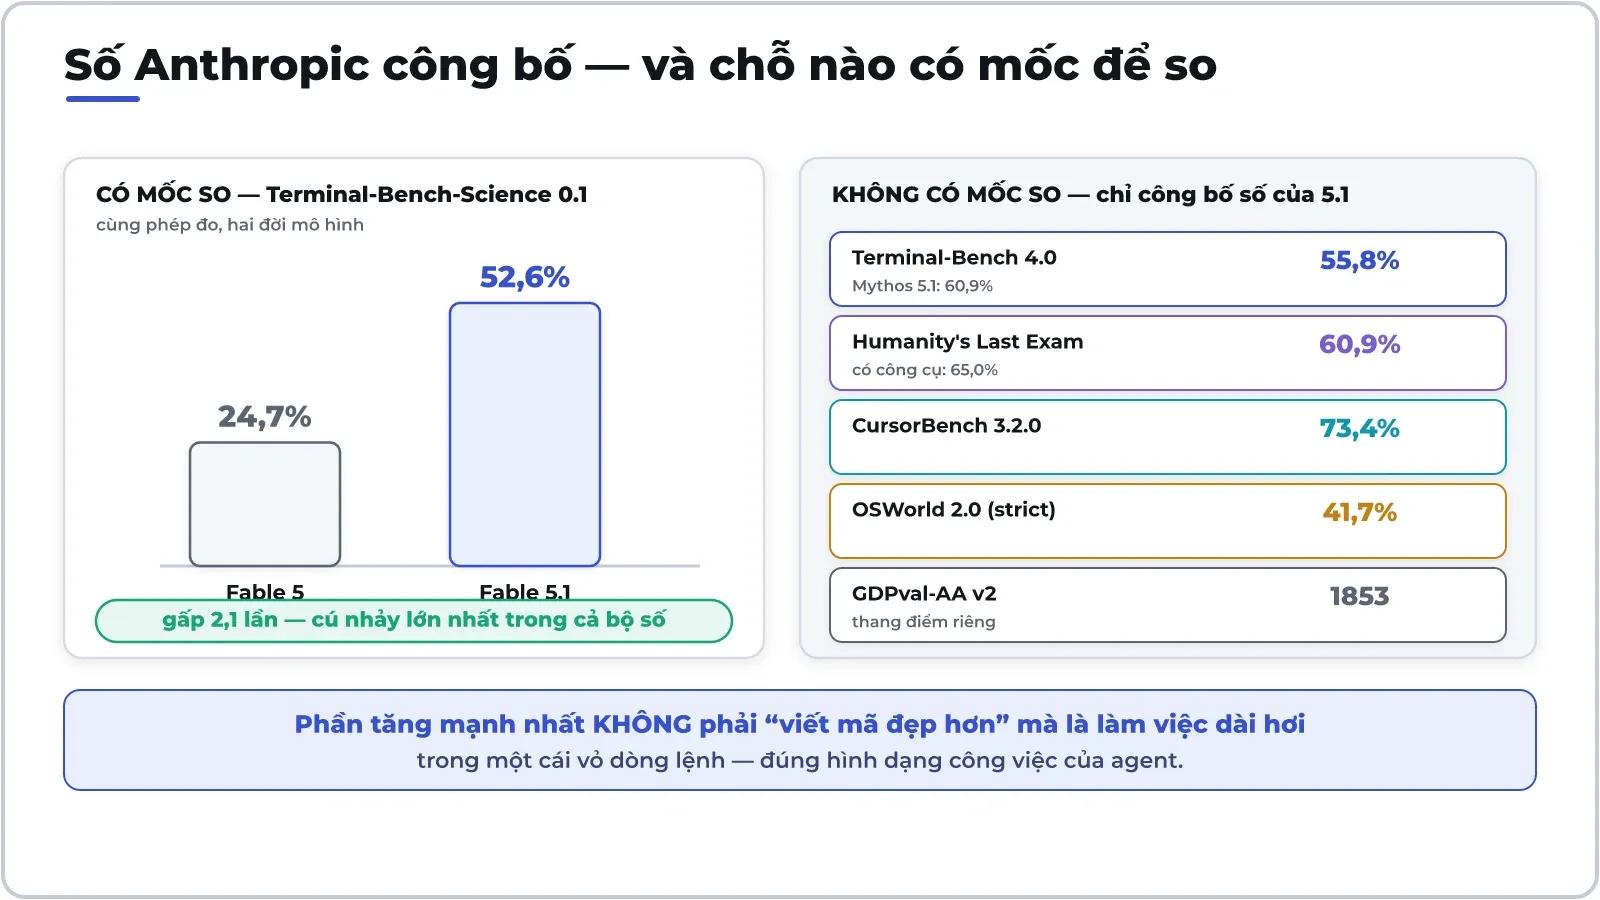
Các con số còn lại — Terminal-Bench 4.0 đạt 55,8% (bản Mythos 5.1 đạt 60,9%), Humanity’s Last Exam 60,9% khi không có công cụ và 65,0% khi có, CursorBench 3.2.0 đạt 73,4%, OSWorld 2.0 bản nghiêm ngặt 41,7%, GDPval-AA v2 đạt 1853 — đều chỉ có số của phiên bản mới. Chúng cho biết mô hình mạnh cỡ nào, nhưng không cho biết nó tiến bộ bao nhiêu. Đó là hai câu hỏi khác nhau, và nhầm lẫn giữa chúng là cách dễ nhất để đọc sai một thông cáo.
Điều bảng số này thật sự nói ra nằm ở chỗ cú nhảy lớn nhất rơi vào đâu: một phép đo về làm việc dài hơi trong môi trường dòng lệnh, không phải một phép đo về viết mã cho đẹp. Đó đúng là hình dạng công việc của một agent — nhận một mục tiêu mơ hồ, tự mò trong một cái vỏ shell, tự sửa khi sai, chạy hàng chục lượt mà không có ai cầm tay.
Ở phía khoa học, hãng đưa ra hai ví dụ cụ thể thay cho điểm số: tỉ lệ thành công gần 50% trong bài toán thiết kế protein, và một bản đồ độ cao bề mặt sao Kim với độ chi tiết cải thiện 2–3 km. Đây là loại kết quả đo bằng sản phẩm chứ không bằng thang điểm — và cũng là loại khó kiểm chứng độc lập nhất.
Một lưu ý về phương pháp, đúng tinh thần bài về cuộc đua mô hình: tất cả những con số trên đều do chính nhà sản xuất công bố. Chúng đáng đọc, nhưng không thay được phép đo trên chính công việc của bạn.
Suy nghĩ không còn là một cái công tắc
Đây là chỗ API bắt đầu nói thẳng. Trên Fable 5.1, suy nghĩ luôn bật và không tắt được. Gửi thinking: {type: "disabled"} thì nhận lỗi 400. Gửi kiểu cũ budget_tokens — tức ấn định trước một ngân sách token để mô hình nghĩ — cũng nhận lỗi 400.
Thay vào đó là một tham số khác hẳn về bản chất: effort, năm mức từ low tới max. Khác biệt không nằm ở cú pháp mà ở chỗ ai là người phải đoán. Ngân sách token bắt bạn đoán trước bài toán khó tới đâu, rồi cấp đúng ngần ấy — đoán thiếu thì mô hình bị cắt ngang giữa chừng, đoán thừa thì trả tiền cho phần không dùng. Còn effort chỉ nói “cố tới mức nào” rồi để mô hình tự phân bổ theo từng bước. Người biết bài toán khó tới đâu là người đang giải nó, không phải người đặt hàng.
Chuỗi suy luận thô thì không bao giờ được trả về, dưới bất kỳ thiết lập nào. Bạn chỉ chọn được cách hiển thị: mặc định là bỏ trống, summarized trả về một bản tóm tắt đọc được, và updates — mới ở đời này — trả về những ghi chú tiến độ ngắn mà mô hình viết giữa các lượt gọi công cụ.
Cái tuỳ chọn thứ ba đó sinh ra từ một vấn đề rất thực tế: một lượt gọi trên bài toán khó có thể chạy nhiều phút. Với giao diện người dùng, nhiều phút im lặng không phân biệt được với treo máy. Nên nếu bạn định dùng mô hình này cho thứ gì đó người thật ngồi chờ, hãy tính lại từ đầu chuyện luồng dữ liệu và thời gian chờ — đây không còn là mô hình trả lời trong hai giây.
Cuốn sổ không được xé trang
Và đây là thay đổi âm thầm nhất, nhưng nặng ký nhất với bất kỳ ai đang dựng agent.
Trên Fable 5.1, các khối suy nghĩ gắn chặt vào đúng mô hình đã sinh ra chúng và đúng vị trí của chúng trong lịch sử hội thoại. Sửa lại một lượt đã qua thì toàn bộ khối suy nghĩ phía sau mất hiệu lực. Với tài khoản mở từ ngày 31/8/2026 trở đi, việc đó không còn là cảnh báo mà là lỗi 400 thẳng thừng. Anthropic gọi cơ chế này là preserved thinking — suy nghĩ được bảo toàn.
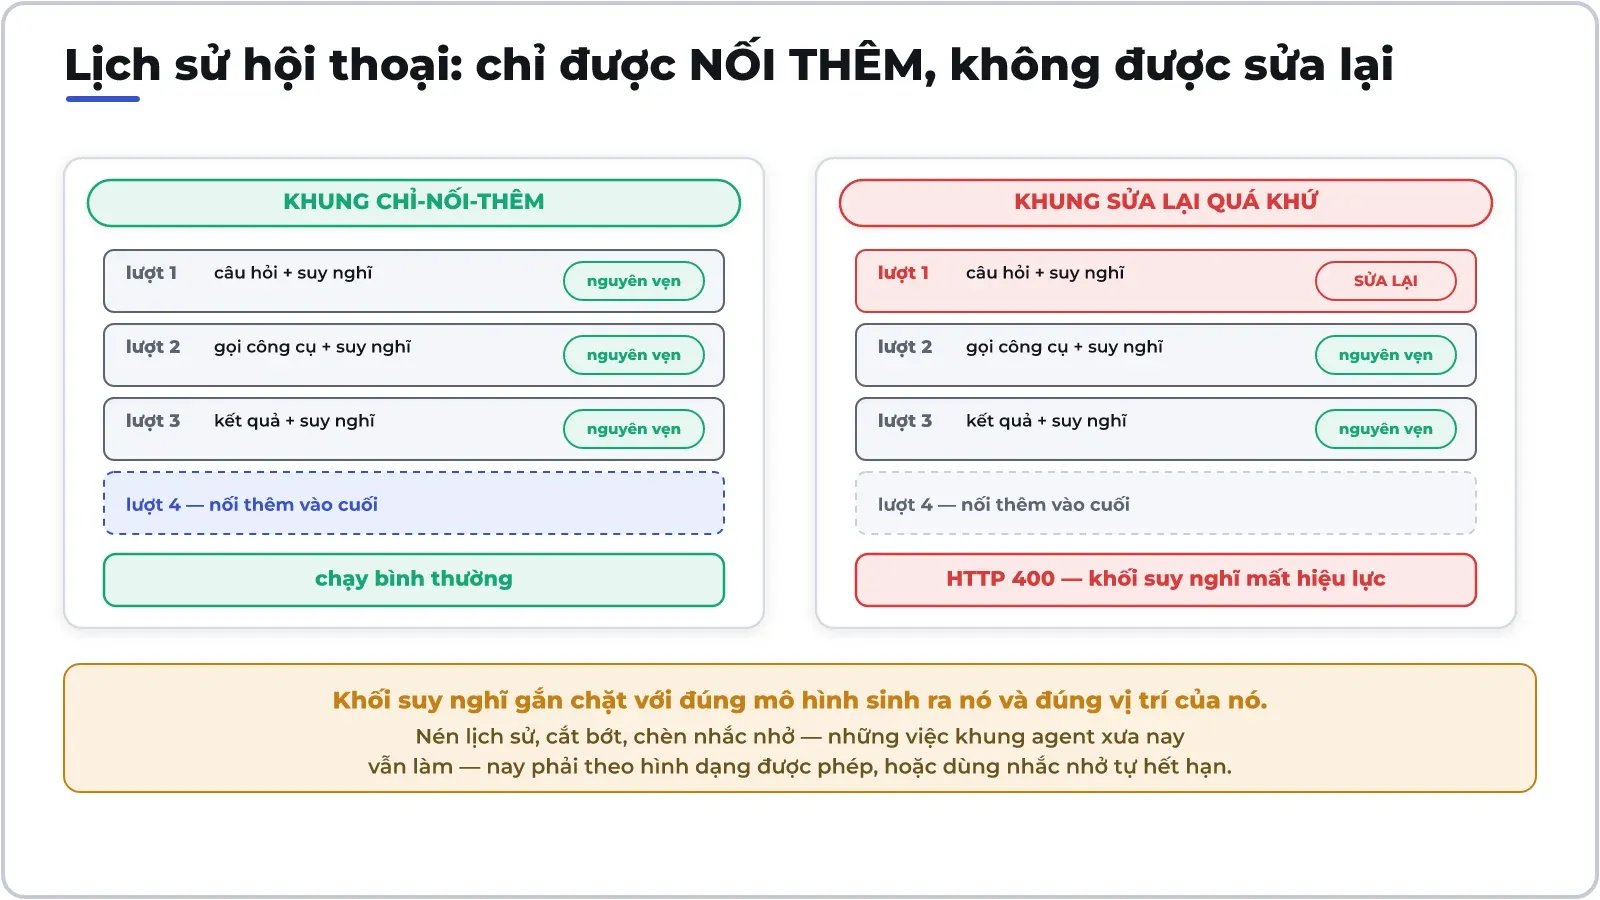
Để thấy vì sao nó nặng, phải nhớ các khung agent xưa nay làm gì với lịch sử hội thoại: viết lại nó thoải mái. Nén phần cũ cho đỡ tốn ngữ cảnh. Cắt bớt kết quả công cụ dài. Chèn một dòng nhắc nhở vào giữa. Sửa lại câu hỏi cũ cho gọn rồi gửi lại cả mớ. Toàn bộ những việc đó dựa trên một giả định chưa ai nói ra: quá khứ là bản nháp, muốn sửa lúc nào cũng được.
Fable 5.1 bỏ giả định ấy. Quá khứ nay là bằng chứng, không phải bản nháp. Khung của bạn phải trở thành khung chỉ-nối-thêm: mọi thứ mới đi vào cuối, không có ngoại lệ. Muốn nhắc mô hình điều gì mỗi lượt thì dùng loại thông điệp hệ thống tự hết hạn (clear_at: "next_user_message") — nó hiện đúng một lượt rồi tự nằm im, thay vì bạn phải đi xoá bản cũ. Còn muốn nén lịch sử thì phải nén theo đúng hình dạng được phép, chứ không tự cắt dán.
Nhìn rộng ra, đây là cùng một dòng chảy với thứ tôi đã viết trong bài về hạt giống: kết quả lặp lại được đang dần trở thành thứ bán được. Một mô hình có thể chứng minh “đây đúng là chuỗi suy luận đã dẫn tới câu trả lời kia, không ai sửa ở giữa” là một mô hình dùng được cho kiểm toán. Cái giá phải trả là sự tự do của người viết khung.
Hai chỗ khác: ép gọi công cụ, và lời từ chối
Ép gọi công cụ đã bị bỏ. Kiểu cũ — bắt mô hình phải gọi một công cụ cụ thể — nay trả về 400. Lý do khá rõ khi nhìn vào mục đích thật của nó: phần lớn người ta ép gọi công cụ chỉ để lấy về một khối JSON đúng khuôn. Nay có đường thẳng hơn cho việc đó: bật strict trên định nghĩa công cụ để tham số luôn hợp lệ, hoặc dùng đầu ra có cấu trúc. Một lối tắt bị bịt vì đã có đường chính.
Lời từ chối trở thành một trạng thái phải xử lý. Khi bộ phân loại an toàn chặn một yêu cầu, API không trả lỗi — nó trả HTTP 200 kèm stop_reason: "refusal" và một mã phân loại. Nghĩa là mã nào đọc thẳng nội dung mà không kiểm stop_reason trước sẽ đọc phải chuỗi rỗng và không hiểu vì sao. Bù lại có một cái van mới: khai báo fallback thì khi bị từ chối, API tự chạy lại đúng yêu cầu đó trên một mô hình khác ngay trong cùng một lời gọi, và lượt bị từ chối trước khi kịp sinh chữ thì không tính tiền.
Ghép cái van này với một con số trong thông cáo thì thấy cả bức tranh: Anthropic nói người dùng Claude Code sẽ gặp ít hơn khoảng 60% số lần bị rào chắn an ninh mạng can thiệp mỗi phiên so với Fable 5, và mô hình nay được phép dùng để tìm lỗ hổng phần mềm. Đó là hai nửa của cùng một việc: nới cho đúng chỗ, và chuẩn bị sẵn đường thoát cho những lần vẫn chặn nhầm. Chặn nhầm là thuế mà người dùng chính đáng phải trả cho rào chắn; giảm thuế đó là một tính năng thật, không phải chuyện làm màu.
Góc kinh tế: chỗ rẻ đi nằm ở bộ nhớ đệm
Quay lại nghịch lý ở đầu bài. Giá token vào và ra không đổi. Thứ đổi là giá đọc lại từ bộ nhớ đệm: rẻ hơn 75%, còn 0,25 đô một triệu token.
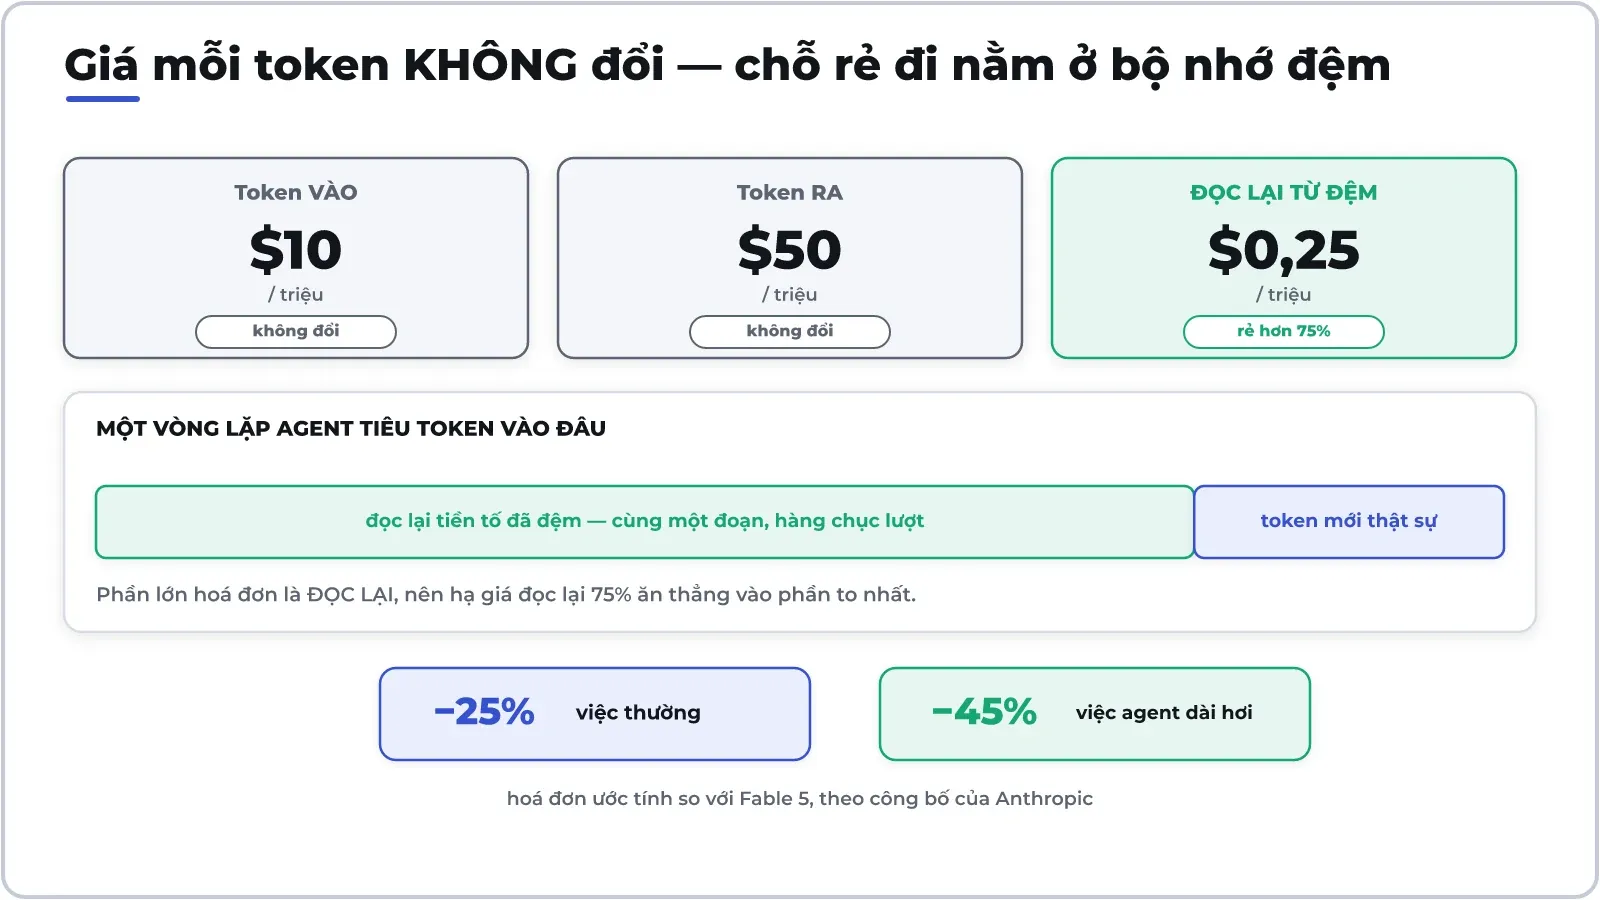
Vì sao một thay đổi nghe hẹp như vậy lại kéo được hoá đơn xuống một phần tư? Vì trong một vòng lặp agent, phần lớn token bạn trả tiền không phải token mới. Agent chạy hai mươi lượt thì hai mươi lần gửi lại gần như cùng một tiền tố: mô tả hệ thống, danh sách công cụ, lịch sử từ đầu. Phần sinh mới mỗi lượt chỉ là một mẩu. Hạ giá phần đọc lại là hạ giá đúng cái phần to nhất của hoá đơn — và đó cũng là lý do hãng ước tính việc thường tiết kiệm khoảng 25% còn việc agent dài hơi tiết kiệm tới khoảng 45%.
Ba hệ quả thực dụng đi ra từ đó.
Một: giữ tiền tố ổn định nay là đòn bẩy rẻ tiền nhất bạn có. Bộ nhớ đệm khớp theo tiền tố — một byte đổi ở đầu là hỏng toàn bộ phần sau. Một dấu thời gian trong mô tả hệ thống, một danh sách công cụ xếp không cố định, là đủ để mỗi lượt phải trả giá đầy đủ. Trước đây lỗi này tốn tiền; nay nó tốn nhiều hơn hẳn, vì phần bạn đánh mất đã rẻ đi bốn lần.
Hai: effort là cái núm chỉnh chi phí thứ hai, và nó thật. Cùng một mô hình, hạ mức cố gắng xuống là bớt token suy nghĩ, bớt lượt gọi công cụ, bớt lời dẫn. Với việc phân loại hay hỏi đáp ngắn, mức thấp thường không mất gì; với việc lập trình dài hơi thì nâng mức lên mới đáng.
Ba: đo chi phí trên mỗi VIỆC XONG, đừng đo trên mỗi lượt gọi. Fable 5.1 đắt gấp đôi Opus 5 — 10/50 đô so với 5/25 đô — và gấp năm lần Sonnet 5. Một lượt gọi rẻ hơn mà phải chạy ba vòng mới xong việc thì không hề rẻ hơn. Đây là phép so duy nhất có nghĩa, và cũng là phép so mà chỉ dữ liệu của chính bạn trả lời được. Xem thêm bài về thuật toán quyết định giá mỗi token để hiểu vì sao con số trên bảng giá không phải con số bạn thật sự trả.
Cuối cùng là hai cái giá không tính bằng tiền, và chúng có thể là thứ chặn bạn lại: Fable 5.1 đòi chế độ lưu dữ liệu 30 ngày — tổ chức nào đang chạy chế độ không lưu dữ liệu sẽ bị từ chối thẳng trừ khi được Anthropic cho phép riêng — và nó không có Priority Tier, tức không mua được suất ưu tiên khi hệ thống đông.
Dự đoán
- “Chỉ nối thêm” sẽ thành mặc định của mọi khung agent. Khi một nhà cung cấp lớn biến việc viết lại lịch sử thành lỗi cứng, các thư viện sẽ chuyển theo — và thói quen tự ý cắt dán ngữ cảnh sẽ được nhớ tới như một giai đoạn tạm bợ.
- Mặt trận giá chuyển từ token sang bộ nhớ đệm. Giá mỗi token đã đứng yên hai đời mô hình liên tiếp trong khi giá đọc lại giảm 75%. Cạnh tranh về giá sẽ diễn ra ở phần “đọc lại cái đã biết”, vì đó mới là chỗ khối lượng thật nằm.
- Mức cố gắng sẽ lộ ra tới tay người dùng cuối. Hôm nay
effortlà tham số của lập trình viên; sẽ sớm có sản phẩm cho người dùng tự chọn “trả lời nhanh” hay “nghĩ kỹ, đắt hơn” ngay trên giao diện. - Cách chia Fable/Mythos sẽ được bắt chước. Tách năng lực khỏi quyền — cùng mô hình, khác rào chắn tuỳ người dùng đã xác minh — giải được thế lưỡng nan mà mọi phòng thí nghiệm đều đang mắc, nên khó có chuyện chỉ một hãng làm.
- Nguồn gốc nội dung sẽ đi từ tính năng sang điều khoản hợp đồng. Khi đã gắn dấu được nội dung do mô hình sinh ra, bên mua trong các ngành có quản lý sẽ bắt đầu yêu cầu dấu đó, chứ không chỉ dùng nếu có sẵn.
- Nhưng bảng điểm tự công bố vẫn sẽ không đủ. Chừng nào chỉ một phép đo trong cả bộ có mốc so sánh cùng đời, người mua nghiêm túc vẫn phải tự dựng bộ đo trên chính công việc của mình — và đó vẫn là việc tốn công nhất trong toàn bộ chuyện này.
Thảo luận