Cập nhật: tháng 9/2026.
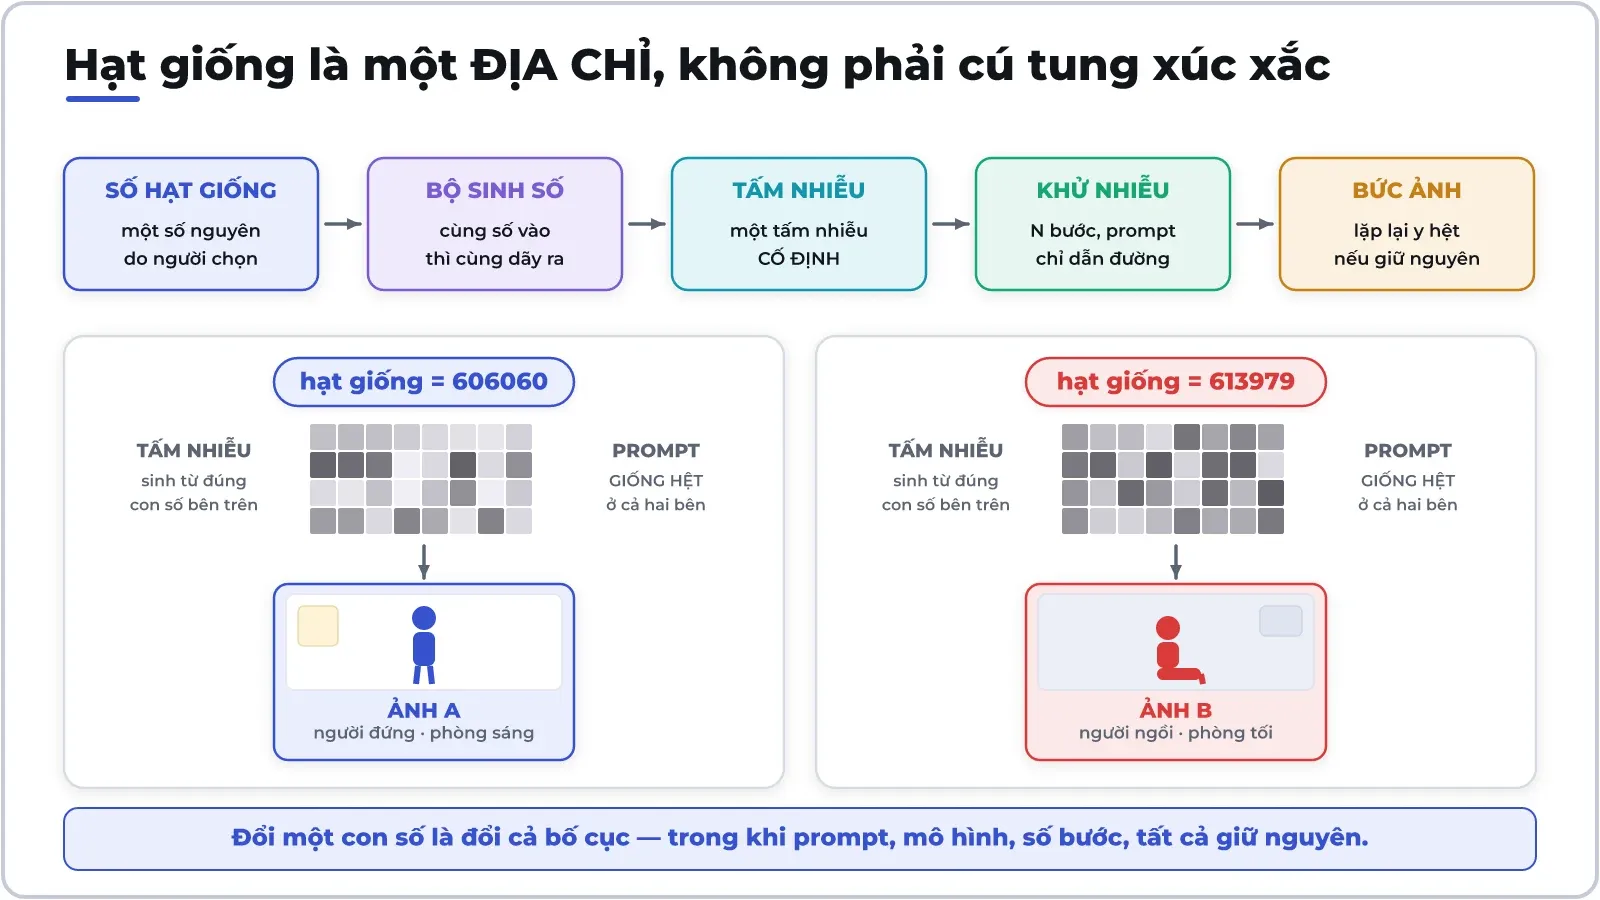
Trong kho ảnh của tôi có hai bức nằm cạnh nhau. Cùng một mô hình, cùng một prompt tới từng dấu phẩy, cùng số bước, cùng bộ lấy mẫu, cùng mọi thứ ghi được trong bảng thông số. Một bức dùng được, một bức vứt đi. Thứ duy nhất khác nhau là một số nguyên nằm lặng lẽ trong metadata — cái mà giới làm AI gọi là hạt giống (seed).
Người mới nhìn nó như một chi tiết kỹ thuật vô nghĩa, một cái nút “ngẫu nhiên” để bấm cho vui. Người làm nghề thì biết nó quyết định nhiều hơn phần lớn câu chữ trong prompt. Và quanh con số ấy đã mọc lên cả một cách làm việc: cách bắt sự ngẫu nhiên phải lặp lại được, cách đi từ một điểm may mắn sang điểm may mắn hơn, và cách trả tiền điện cho những lần không may.
Hạt giống không phải “độ ngẫu nhiên”. Nó là một địa chỉ.
Máy tính hầu như không tạo ra ngẫu nhiên thật. Thứ nó có là bộ sinh số giả ngẫu nhiên: một hàm toán học hoàn toàn xác định, nhận một con số rồi nhả ra một dãy dài trông như hỗn loạn. Nạp cùng một con số thì nhận lại đúng dãy ấy, hôm nay cũng như sang năm. Con số nạp vào chính là hạt giống.
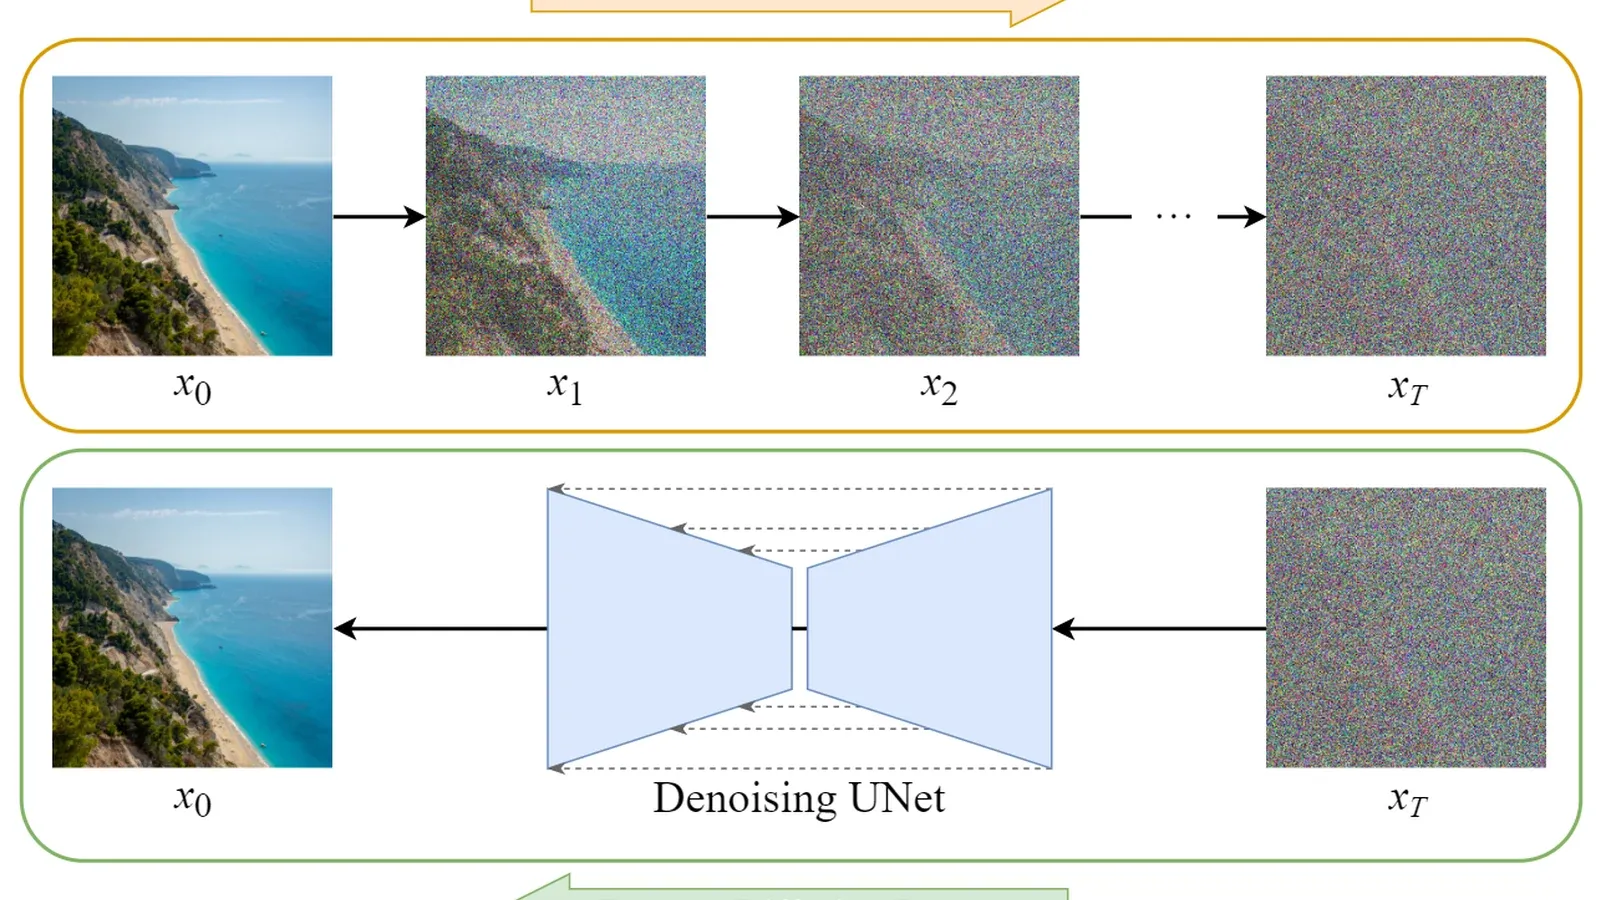
Trong một mô hình khuếch tán, dãy số đó được đổ đầy vào một tấm nhiễu — một khối số cùng kích thước với bức ảnh sắp sinh (thường là ở không gian tiềm ẩn đã nén). Toàn bộ việc “sinh ảnh” sau đó là đi từ tấm nhiễu ấy, mỗi bước gỡ bớt một ít nhiễu, cho tới khi còn lại một bức tranh. Prompt không vẽ gì cả: nó chỉ làm người dẫn đường, nghiêng mỗi bước đi về phía những thứ khớp với câu chữ.
Nên cách hiểu đúng là thế này: trọng số của mô hình dựng nên địa hình, prompt làm nghiêng địa hình, còn hạt giống thả bạn xuống một điểm cụ thể trên đó — rồi bạn lăn xuống thung lũng gần nhất. Đổi hạt giống không phải là “thêm ngẫu nhiên”, mà là đổi chỗ đứng.
Hệ quả của cách hiểu này khá lạ nhưng rất hữu ích: bức ảnh không được vẽ ra, nó được tìm thấy. Nó đã nằm sẵn trong bãi nhiễu từ trước khi bạn bấm nút — bạn chỉ chưa biết mình đang đứng ở đâu.
Vì sao chữ không thắng nổi con số
Tôi từng thử một việc nghe rất hợp lý: đưa cho máy một bức ảnh có sẵn, rồi để nó tự viết prompt, vẽ ra, so với ảnh gốc, sửa prompt, vẽ lại — lặp nhiều vòng, hy vọng hội tụ về bản gốc. Trần đo được dừng ở khoảng 56 trên 100 điểm giống nhau, và không vòng lặp nào phá nổi.
Lý do nằm ở phân công lao động giữa hai thứ. Prompt điều khiển nội dung và phong cách: có ai trong khung, mặc gì, ánh sáng ấm hay lạnh, nét vẽ kiểu gì. Hạt giống điều khiển bố cục: người đứng lệch trái hay lệch phải, tay đặt ở đâu, tỉ lệ đầu so với khung, mảng sáng rơi vào góc nào. Không có cụm từ tiếng Anh nào nói được “bàn tay ở toạ độ này”. Mà bố cục lại là thứ mắt người nhận ra trước tiên.
Từ đó ra một luật thực dụng: đừng hứa tái tạo một bức ảnh chỉ bằng prompt. Muốn giữ được một bức thì phải giữ cả hạt giống, cả model, cả số bước, cả bộ lấy mẫu — thiếu một thứ là mất luôn. Đây cũng là chỗ “nghề viết prompt” chạm trần: quá một mức nào đó, bạn đang cãi nhau với địa hình bằng lời nói.
Hạt giống ẩn ở ba tầng, không riêng gì ảnh
Tầng một — lúc huấn luyện. Trọng số ban đầu của mạng được bốc ngẫu nhiên, thứ tự trộn dữ liệu cũng ngẫu nhiên, các lớp bỏ bớt nơ-ron cũng vậy. Cùng một công thức, đổi hạt giống là ra một mô hình khác, điểm số khác. Giới nghiên cứu gọi hiện tượng này là xổ số hạt giống: một “cải tiến” báo cáo trên đúng một lần chạy đôi khi chỉ là một lần may. Đây là lý do vì sao n = 1 không bao giờ là một kết luận — phải chạy nhiều hạt rồi lấy trung vị.
Tầng hai — lúc sinh chữ. Mô hình ngôn ngữ không “biết” từ tiếp theo; nó đưa ra một phân phối xác suất rồi bốc một từ trong đó. Nhiệt độ và top-p quyết định mức liều lĩnh của cú bốc, còn hạt giống quyết định chuỗi bốc cụ thể. Nhiều API mô hình ngôn ngữ nay đã cho truyền tham số hạt giống, chính vì khách hàng cần chạy lại được. Đây cũng là một mảnh của câu chuyện vì sao mô hình bịa: cùng một câu hỏi, hai lần bốc khác nhau cho hai câu trả lời tự tin như nhau.
Tầng ba — dưới đáy phần cứng, và đây là tầng ít người ngờ nhất. Số thực dấu phẩy động không kết hợp: (a + b) + c không nhất thiết bằng a + (b + c), vì mỗi phép cộng đều làm tròn. Trên GPU, một phép cộng dồn khổng lồ được chia cho hàng nghìn luồng, mà cách chia lại phụ thuộc kích thước lô đang xử lý. Kích thước lô thì phụ thuộc… có bao nhiêu người đang hỏi cùng lúc.
Kết quả là một điều rất phản trực giác: cùng hạt giống, cùng prompt, cùng mô hình, nhưng máy chủ đông khách hay vắng khách lại cho ra chữ khác nhau. Đó là lý do đặt nhiệt độ về 0 vẫn không đủ để có kết quả lặp lại, và là vì sao trong 2025–2026 việc viết các nhân tính toán bất biến theo kích thước lô trở thành một đề tài kỹ thuật được săn đón. Ai cần kiểm toán, cần kiểm thử hồi quy, cần chứng minh “lần trước máy đã trả lời đúng câu này” thì đều cần nó. Xem thêm bảy lầm tưởng phổ biến về mô hình ngôn ngữ.
Đi tiếp từ một hạt giống tốt: dải trơn, rồi vực đứt
Giả sử bạn đã có một hạt giống đẹp và muốn thứ “gần giống, khác một chút” — dựng biến thể, làm một chuỗi ảnh liên tiếp. Kỹ thuật quen thuộc là nội suy giữa hai tấm nhiễu (trượt trên mặt cầu, SLERP) rồi kéo dần độ lệch từ 0 lên.
Câu hỏi đáng tiền là: kéo như vậy thì ảnh đổi đều đặn hay đổi giật cục? Tôi đo trên một dãy sáu ảnh, cùng cặp hạt, chỉ kéo độ lệch.
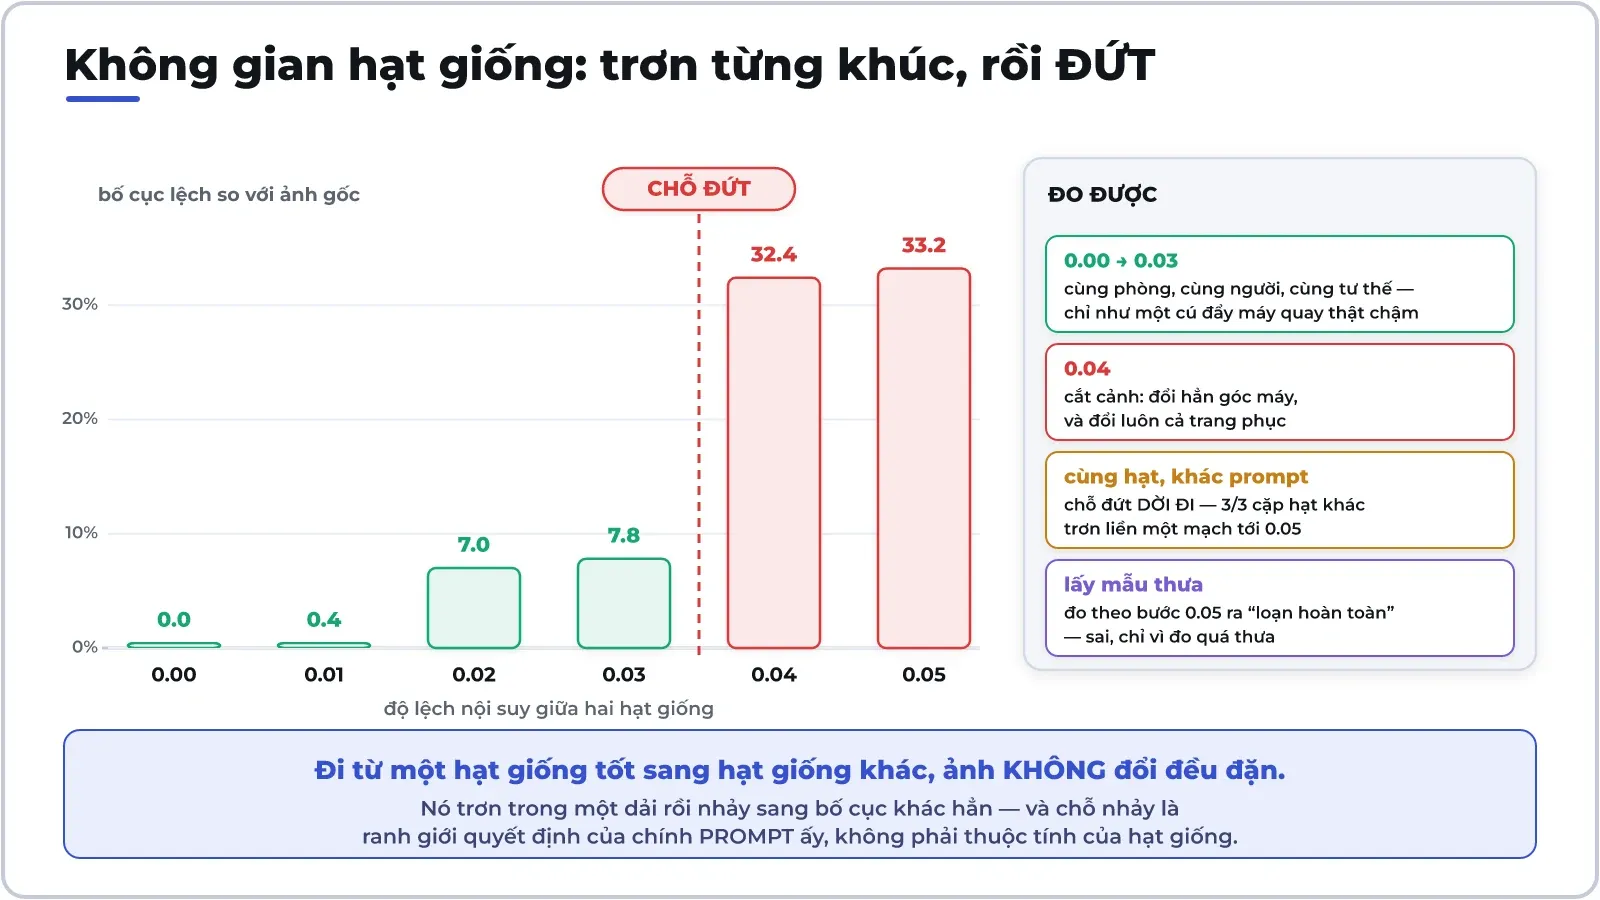
Từ 0,00 đến 0,03, sáu bức gần như là một cú đẩy máy quay thật chậm: cùng căn phòng, cùng con người, cùng tư thế, cùng bộ quần áo. Sang 0,04 thì cắt cảnh: góc máy khác, trang phục đổi, tay đặt kiểu khác. Bố cục lệch nhảy từ 7,8% lên 32,4% chỉ sau một bước.
Nhưng phần thú vị nằm ở phép đo tiếp theo. Chạy lại trên ba cặp hạt giống khác với một prompt khác thì cả ba đều trơn liền một mạch tới 0,05, không cặp nào nhảy. Tức chỗ đứt kia không phải thuộc tính của hạt giống, cũng không phải của kỹ thuật nội suy: nó là ranh giới quyết định của chính prompt ấy — chỗ mà mô hình đổi ý về việc câu chữ này nên trông như thế nào.
Còn một bài học về cách đo. Lần đầu tôi quét theo bước 0,05 và suýt kết luận “đường nội suy loạn hoàn toàn”. Chỉ khi hạ xuống bước 0,01 mới thấy có một dải trơn dài. Lấy mẫu thưa trên một hàm không trơn thì đọc ra nhiễu, và cái nhiễu ấy trông y hệt một kết luận.
Chọn lọc: gieo, chấm điểm, rồi gieo lại
Đến đây lộ ra sự thật khó chịu của nghề: không ai tối ưu được hạt giống. Nó là một số nguyên, hàm từ nó tới “ảnh đẹp” thì gãy khúc và không có đạo hàm. Không có gradient nào để trượt. Chỉ còn đúng một cách: sinh nhiều, chấm điểm, giữ cái tốt — cùng một họ với best-of-n và lấy mẫu có loại bỏ ở mô hình ngôn ngữ.
Thứ biến việc này từ mê tín thành kỹ thuật là bộ chấm tự động. Ở hệ sinh ảnh của tôi, mỗi bức vẽ xong được đo hai chỉ số rẻ tiền trên CPU — tỉ lệ điểm ảnh cháy sáng và độ lệch màu tổng thể — quá ngưỡng thì đổi hạt giống vẽ lại, tối đa ba lượt. Máy tự loại bài của chính nó trước khi con người phải nhìn.
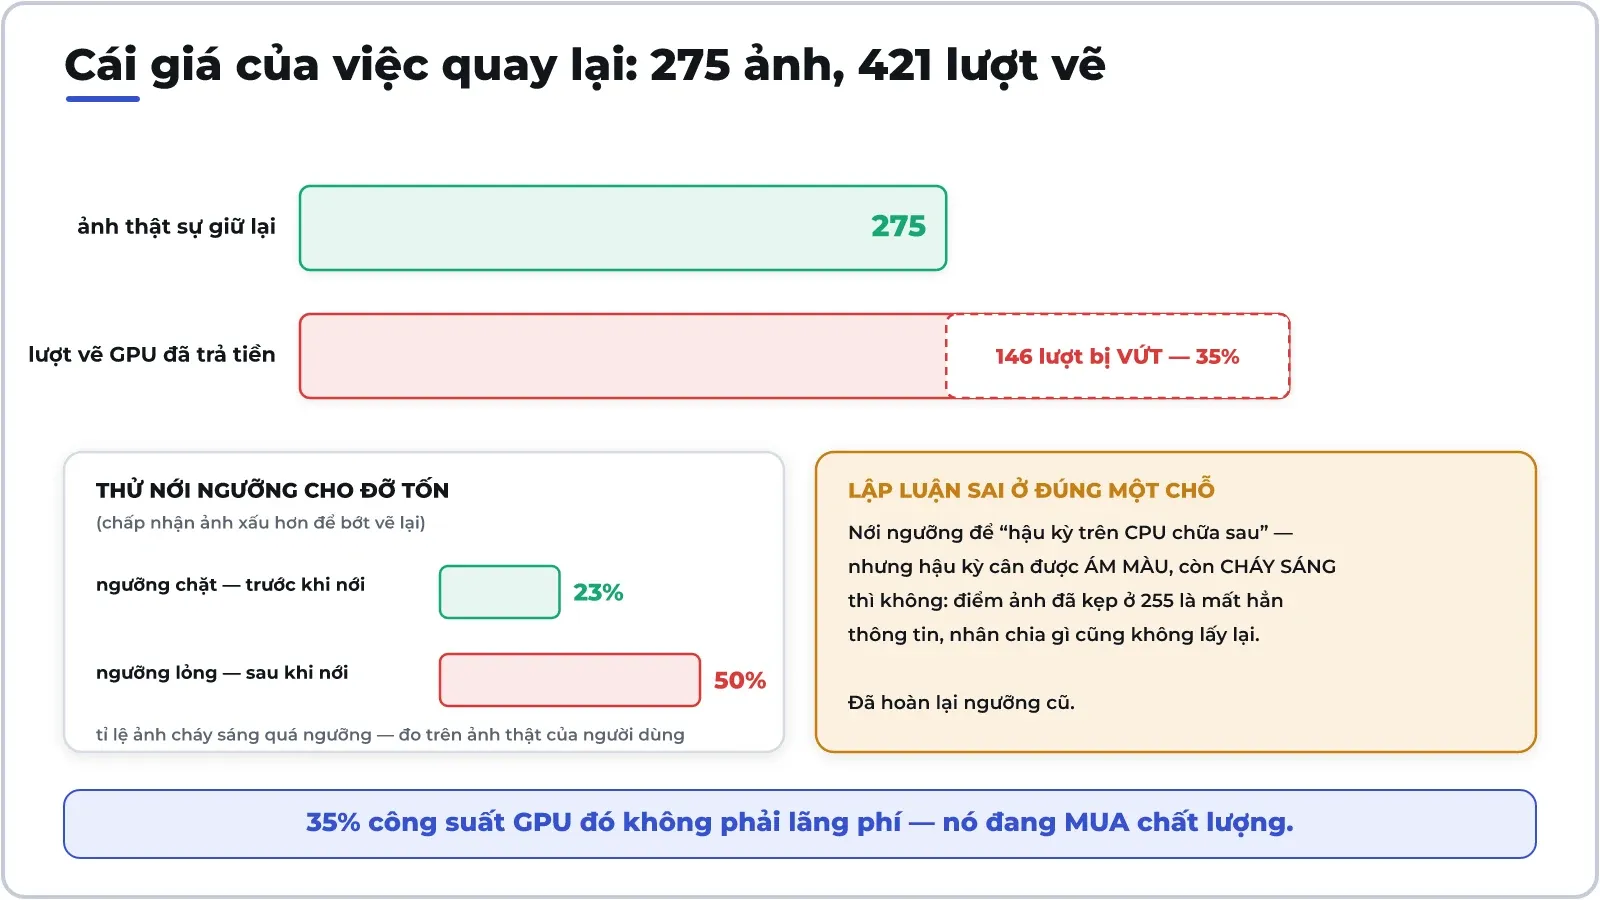
Hoá đơn thì thẳng thắn: 275 bức được giữ lại đã tiêu 421 lượt vẽ GPU — 35% công suất đi thẳng vào sọt rác. Nhìn con số đó, tôi từng nghĩ mình tìm ra chỗ tiết kiệm, nên nới ngưỡng lên cho máy bớt vẽ lại. Kết quả đo sau đó: tỉ lệ ảnh cháy sáng quá mức tăng từ 23% lên 50%, và chủ nhân của kho ảnh nhận ra ngay mà không cần ai chỉ.
Lập luận của tôi sai ở đúng một chỗ: tôi cho rằng cứ để ảnh cháy nhẹ rồi hậu kỳ trên CPU chữa sau. Nhưng hậu kỳ cân được ám màu, còn cháy sáng thì không — điểm ảnh đã kẹp ở 255 là mất hẳn thông tin, nhân chia kiểu gì cũng không lấy lại. Đã trả ngưỡng về như cũ. 35% GPU đó không phải lãng phí; nó đang mua chất lượng.
Góc kinh tế: may rủi được mua bằng điện
Mỗi lần gieo lại là một lượt GPU đầy đủ. Nghĩa là chi phí thật của một bức ảnh không nằm ở lần thành công, mà nằm ở những lần bị vứt — và tỉ lệ vứt do bạn đặt ngưỡng chứ không do mô hình. Ba hệ quả tiền bạc đi ra từ đó.
Một: bộ chấm điểm đắt giá hơn bộ sinh. Mô hình sinh quyết định chất lượng trung bình; bộ chấm quyết định bạn phải trả bao nhiêu lượt để vượt được một ngưỡng. Bộ chấm rẻ mà đúng thì cắt hoá đơn ngay; bộ chấm sai thì hoặc thả rác ra ngoài, hoặc đốt GPU vẽ lại những bức vốn đã đạt.
Hai: quên ghi hạt giống là mua lại thứ đã mua. Một bức đẹp mà không lưu hạt giống thì để tìm lại nó chỉ còn cách gieo mù — mà không gian hạt giống thì lớn tới mức tìm mù là vô vọng. Ghi một con số vào metadata gần như miễn phí; không ghi thì cái giá là toàn bộ lượt GPU đã trả.
Ba: so sánh mô hình bằng một lần chạy là đặt cược vào nhiễu. Chênh lệch giữa hai mô hình đôi khi nhỏ hơn chênh lệch giữa hai hạt giống của cùng một mô hình. Quyết định mua sắm hạ tầng dựa trên một con số như vậy là mua theo may rủi mà tưởng mình mua theo số liệu.
Cùng cấu trúc chi phí đó đang lặp lại ở mô hình ngôn ngữ dưới cái tên “tính toán lúc chạy”: sinh nhiều lời giải, chấm, giữ cái tốt nhất. Hoá đơn tăng theo số lần sinh trong khi mô hình không đổi một tham số nào — giá mỗi token vì thế chỉ là nửa câu chuyện; nửa còn lại là bạn phải sinh bao nhiêu lần mới lấy được một kết quả dùng được.
Cũng vì vậy mà hướng tối ưu đáng giá nhất không phải “vẽ lại nhanh hơn”, mà là đừng vẽ lại toàn bộ. Ở hệ của tôi, sửa cục bộ một vùng nhỏ rồi dán đè lên ảnh cũ tốn khoảng 32–34 giây một khung, so với chừng 50 giây khi vẽ lại đầy đủ — và quan trọng hơn, phần nằm ngoài vùng sửa không đổi một điểm ảnh nào, nên không có nguy cơ hỏng thứ vốn đã tốt. Gieo lại cả bức là cách đắt nhất trong mọi cách sửa.
Nghề thật sự: biến may rủi thành quy trình
Gộp lại, cái gọi là “kỹ sư AI tối ưu kết quả” hoá ra không phải chuyện điều khiển sự ngẫu nhiên. Nó là năm thói quen rất đời thường:
- Ghi hạt giống vào chính sản phẩm, không ghi ra sổ bên ngoài. Metadata nhúng trong file sống lâu hơn mọi bảng tính.
- Đo bằng nhiều hạt, báo cáo trung vị, đừng báo cáo bức đẹp nhất — bức đẹp nhất luôn tồn tại, kể cả với một phương pháp tồi.
- Ghim hạt giống trong kiểm thử, để khi kết quả đổi thì biết chắc là do mình vừa sửa gì đó, chứ không phải do hôm nay máy bốc khác.
- Phân biệt “hết may” với “sai cách”. Mười hạt giống cùng hỏng theo một kiểu thì lỗi nằm ở prompt, ở khổ ảnh, ở tham số — gieo tiếp chỉ tốn điện.
- Giữ một thư viện hạt giống tốt kèm điều kiện đi cùng (mô hình nào, khổ nào, bộ lấy mẫu nào). Đổi mô hình là cả thư viện ấy mất giá trị, vì địa hình đã khác.
Điều mỉa mai dễ chịu là ở chỗ này: người làm nghề giỏi không may mắn hơn người khác. Họ chỉ ghi lại được chỗ mình đã may và quay về đó được. Trong một bãi nhiễu không có gì để bám, đó đã là toàn bộ lợi thế.
Dự đoán
- Kết quả lặp lại được sẽ thành thứ bán được. Khi mô hình đi vào kiểm toán, y tế, pháp lý, các nhà cung cấp sẽ chào “chế độ tất định” như một mức dịch vụ riêng — chậm hơn, đắt hơn, đổi lại chạy lại là ra đúng chữ cũ.
- Hạt giống trở thành một phần của nguồn gốc sản phẩm. Ảnh và văn bản do AI sinh sẽ mang theo hạt giống, phiên bản mô hình và phiên bản nhân tính toán như một “hoá đơn nguyên liệu” — vừa để tái tạo, vừa để chứng minh.
- Bộ chấm điểm tự động sẽ hút đầu tư nhiều hơn bộ sinh. Khi mọi người dùng chung vài mô hình nền, thứ tạo ra khác biệt là bạn lọc giỏi tới đâu và trả bao nhiêu lượt cho một kết quả đạt.
- Báo cáo nhiều hạt giống sẽ thành yêu cầu tối thiểu. So sánh mô hình bằng một lần chạy sẽ dần bị coi là số liệu không dùng được, giống như cách ngành phần mềm đã bỏ thói đo hiệu năng bằng một lần bấm giờ.
- Sửa cục bộ sẽ thay dần gieo lại. Vá đúng vùng hỏng rẻ hơn và an toàn hơn vẽ lại cả khung; công cụ nào biến được “chỗ này chưa ưng” thành một vùng cần sửa sẽ ăn phần lớn nhu cầu chỉnh sửa.
- Nhưng bãi nhiễu vẫn còn đó. Chừng nào việc sinh còn bắt đầu từ một điểm bốc ngẫu nhiên, chừng đó vẫn còn nghề gieo và chọn — công cụ chỉ làm cho việc gieo rẻ đi và việc chọn khôn hơn.
Thảo luận