更新:2026年9月。
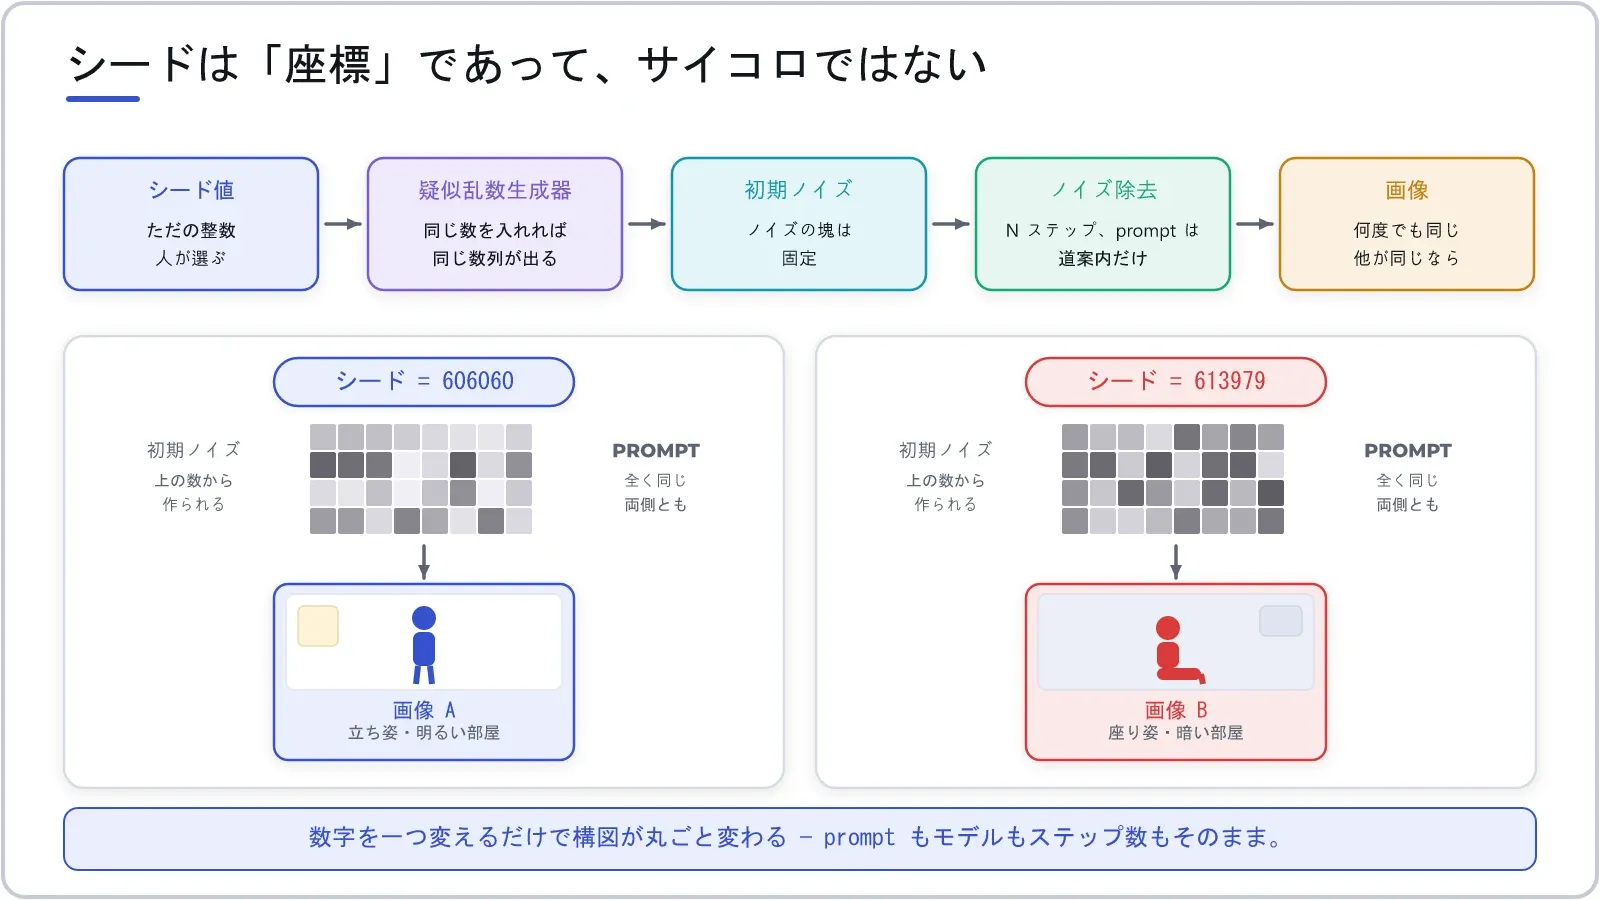
私の画像ライブラリには、隣り合って並んでいる2枚の画像があります。同じモデル、コンマ1つに至るまで同じプロンプト、同じステップ数、同じサンプリングセット、パラメータ表に記録されているすべての項目が同じです。 1枚は使えるが、もう1枚は使い物にならない。唯一異なるのは、メタデータの中にひっそりと潜む整数――AI業界で「シード(seed)」と呼ばれるもの――だけだ。
初心者は、これを意味のない技術的な細部、ただ面白半分に押す「ランダム」なボタンだと見なす。 しかし、この業界に身を置く者なら、それがプロンプト内の文章の大部分よりもはるかに大きな決定要因であることを知っている。そして、その数字を巡って、ある一連の作業方法が確立されてきた。つまり、偶然性を再現可能にする方法、幸運なポイントからさらに幸運なポイントへと進む方法、そして不運な結果が出た際の代償を支払う方法である。
種は「ランダム」なものではありません。それはアドレスなのです。
コンピュータは、真のランダム性をほとんど生み出さない。 コンピュータが持っているのは「疑似乱数生成器」と呼ばれるもので、これは完全に確定された数学的な関数であり、ある数値を入力すると、一見無秩序に見える長い数列を出力する。同じ数値を入力すれば、今日でも来年でも、まったく同じ数列が返ってくる。入力される数値こそが「シード」である。
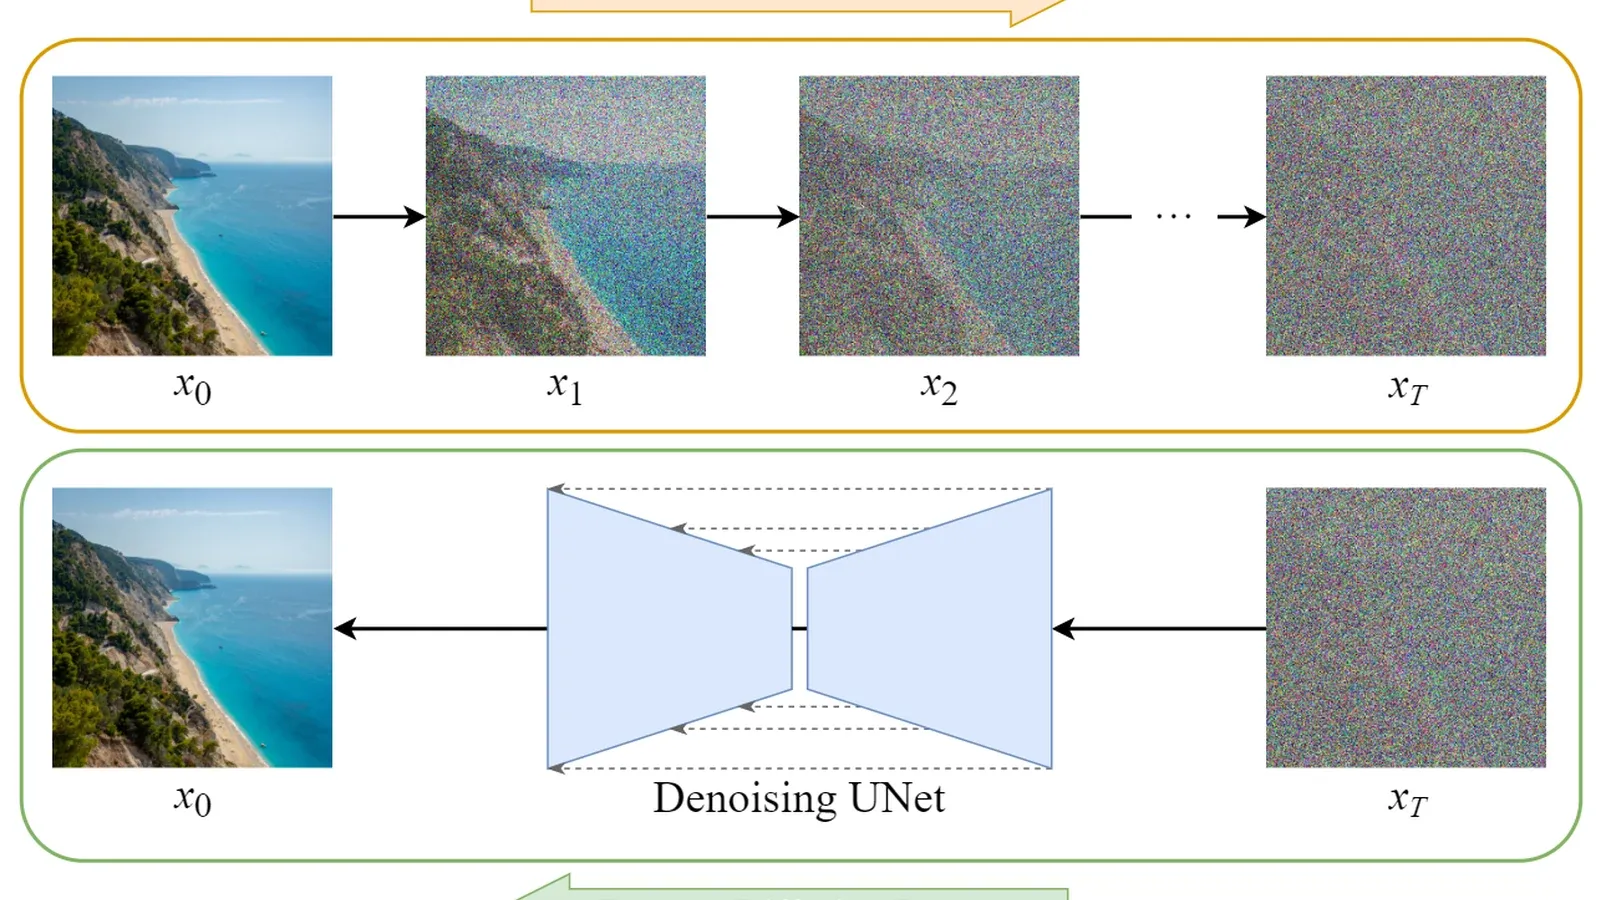
拡散モデルでは、その数列はノイズのブロック――生成される画像と同じサイズの数値の塊(通常は圧縮された潜在空間内)――に埋め込まれます。 その後の「画像生成」の全工程は、そのノイズブロックから始まり、各ステップで少しずつノイズを取り除き、最終的に画像が残るまで続きます。プロンプトは何も描くわけではありません。それは単なる道しるべであり、各ステップで文章に合致する方向へと導いていくだけです。
したがって、正しい理解は次のようになります。モデルの重みが地形を作り出し、プロンプトが地形を傾け、シードがその上の特定の地点にあなたを配置し――そしてあなたは最も近い谷へと転がり落ちるのです。シードを変更することは「ランダム性を加える」ことではなく、立ち位置を変えることなのです。
この解釈から導かれる結論は少々奇妙ですが、非常に有用です。写真は「描かれる」のではなく、「発見される」のです。シャッターを切る前から、それはノイズの中にすでに存在していた――ただ、自分がどこに立っているのか、まだ気づいていなかっただけなのです。
なぜ文字は数字に勝てないのか
以前、とても理にかなっていると思われる方法を試したことがある。手元にある写真をAIに与え、AIにプロンプトを自動生成させて描画させ、元の写真と比較し、プロンプトを修正して再描画する――というプロセスを何度も繰り返し、最終的に元の写真に近づけることを目指したのだ。 類似度は100点満点中56点程度で頭打ちとなり、どの反復でもそれを上回ることはできませんでした。
その理由は、この2つの役割分担にあります。プロンプトは内容とスタイルを制御します。フレーム内に誰がいるか、何を着ているか、暖色系か寒色系の照明か、どのような画風かといった点です。 一方、シードは構図を制御します:人物が左寄りに立っているか右寄りに立っているか、手の位置、頭とフレームの比率、光の当たる場所などです。「手がこの座標にある」と表現する英語のフレーズは存在しません。しかし、構図こそが、人間の目が真っ先に認識する要素なのです。
そこから実用的なルールが導き出される:プロンプトだけで写真を再現すると約束してはいけない。 1枚の画像を保存したいなら、シード、モデル、ステップ数、サンプリングセットのすべてを保存しなければならない――どれか一つでも欠ければ、その画像は永久に失われてしまう。こここそが「プロンプト作成という仕事」の限界である。あるレベルを超えると、言葉だけで地形と戦っているようなものだからだ。
3つの階層に隠された種は、写真だけにとどまらない
第1層 — 学習時。ネットワークの初期重みはランダムに設定され、データのシャッフル順序もランダムであり、ニューロンを削除する層も同様である。同じ式でも、シードを変更するだけで異なるモデルが得られ、スコアも異なる。 研究者の間では、この現象を「シードの宝くじ」と呼んでいる。ある実行で報告された「改善」は、単に一度の幸運に過ぎない場合があるのだ。これが、n = 1では決して結論が出せない理由である――多くの実行を行い、その中央値を取り出す必要がある。
第2段階 — 文字の生成。言語モデルは次の単語を「知っている」わけではなく、確率分布を提示し、そこから単語を1つ抽出します。温度とtop-pは抽出の「大胆さ」を決定し、シードは具体的な抽出シーケンスを決定します。 現在、多くの言語モデルAPIではシードパラメータの指定が可能になっており、これはユーザーがモデルを再実行できるようにするためである。これは、モデルが「でたらめ」な回答を生成する理由の一端でもある。同じ質問に対して、2回の異なるサンプリングで、同じくらい確信度の高い2つの回答が得られることがあるのだ。
第3層 — ハードウェアの最下層にあり、これは最も予想外の層です。浮動小数点数の加算は結合律を満たしません。(a + b) + c は必ずしも a + (b + c) と等しくならないのです。なぜなら、各加算操作で丸めが行われるからです。 GPU上では、巨大な累積加算が数千のスレッドに分割されますが、その分割方法は処理中のバッチサイズに依存します。バッチサイズは……同時にクエリを送信しているユーザーの数に依存します。
その結果、非常に直感に反する現象が明らかになりました。同じシード、同じプロンプト、同じモデルであっても、サーバーのアクセス数が多かろうが少なかろうが、生成されるテキストが異なってしまうのです。 これが、温度を0に設定しても再現性のある結果が得られない理由であり、2025年から2026年にかけて、バッチサイズに依存しない計算ルーチンの記述が注目される技術的テーマとなった所以である。 監査や回帰テストが必要だったり、「前回、この質問に対してモデルが正しい回答を出していた」ことを証明する必要がある人なら、誰でもこれを必要とするだろう。言語モデルに関する7つのよくある誤解についても参照のこと。
良き種からさらに進む:平坦な道、そして断崖絶壁
美しい種画像があり、そこから「似ているが、少し異なる」ものを作りたいと仮定しましょう――バリエーションを作成し、連続した画像シーケンスを作るのです。よく使われる手法は、2枚のノイズ画像の間を補間(球面上のスライド、SLERP)し、その偏差を0から徐々に増やしていくものです。
重要な疑問は、このようにスライドさせると、画像は滑らかに切り替わるのか、それともぎくしゃくして切り替わるのか、ということです。私は、同じチップペアの6枚の画像の系列を用いて、オフセットのみを変化させて測定を行いました。
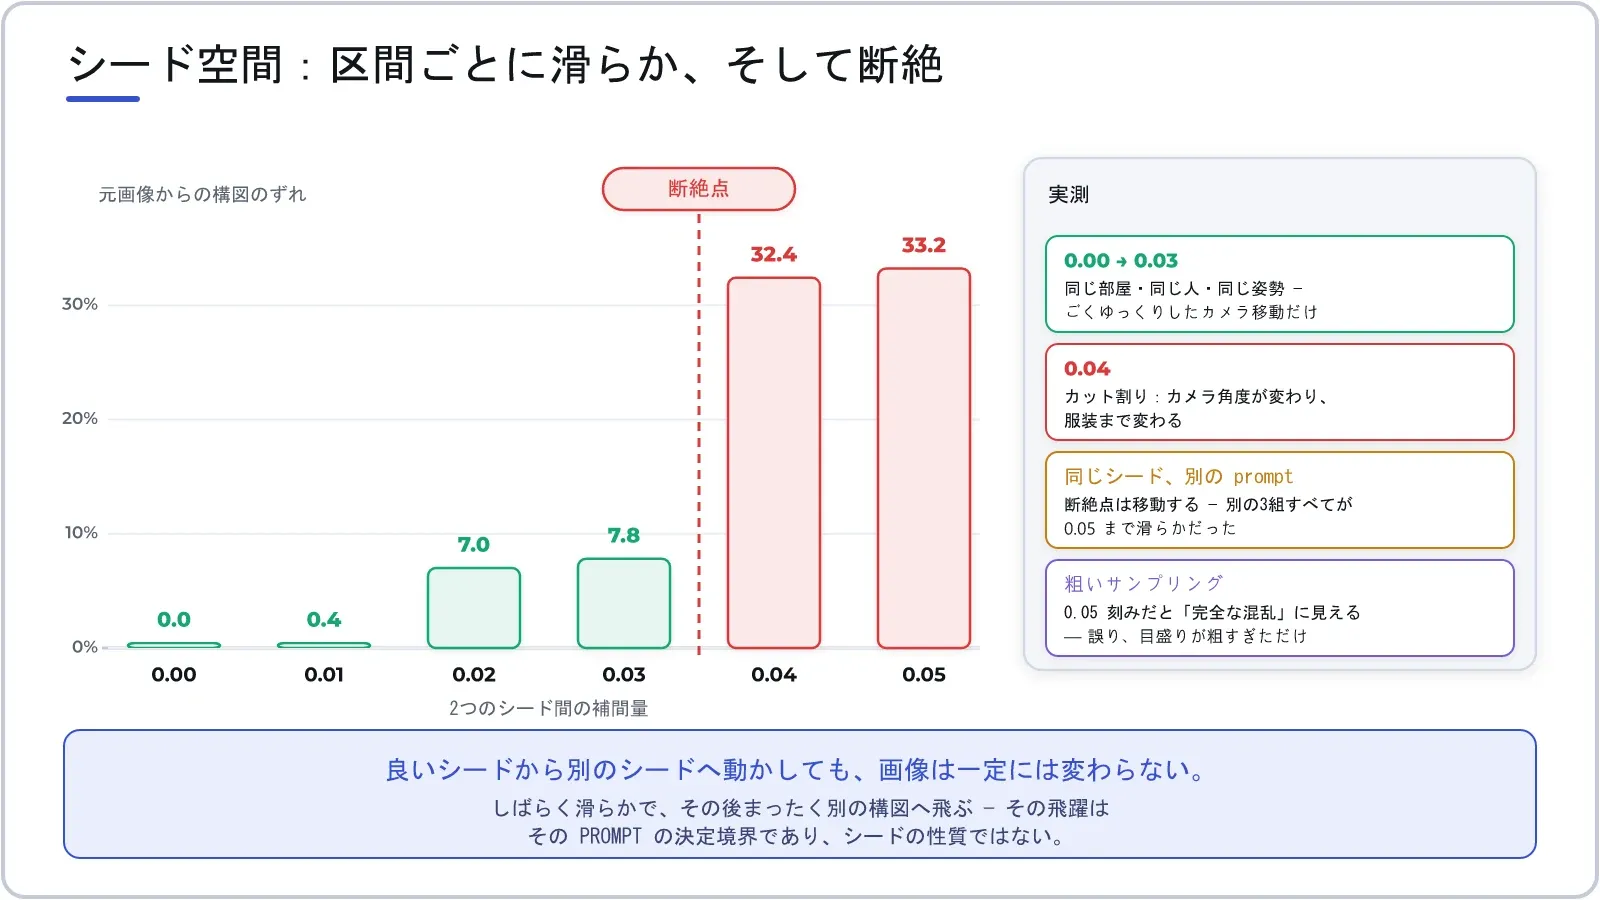
0.00から0.03にかけて、6つのカットはまるでスローモーションのカメラワークのようだ:同じ部屋、同じ人物、同じ姿勢、同じ服装。0.04になるとカットが変わり、カメラアングルが変わり、服装が変わり、手の置き方も変わる。 構図の偏りが、たった1ステップで7.8%から32.4%へと跳ね上がった。
しかし、興味深いのは次の測定結果です。別のプロンプトを使って他の3組のシードで再実行したところ、3組とも0.05まで滑らかに到達し、跳ね上がるペアは1つもありませんでした。 つまり、あの切れ目はシードの属性でもなければ、補間手法によるものでもない。それは、そのプロンプト自体の決定的な境界線――モデルが「この文章はどのように見えるべきか」という考えを変える地点――なのだ。
測定方法に関するもう一つの教訓がある。最初は0.05ステップでスキャンしたところ、「補間曲線が完全に乱れている」と結論づけそうになった。0.01ステップに下げて初めて、滑らかな長い帯が現れたのだ。 滑らかでない関数上でサンプリング間隔を広く設定すると、ノイズが読み取られ、そのノイズはまるで結論のように見えてしまうのです。
選別:種をまき、選別し、再び種をまく
ここで、この職業の厄介な真実が明らかになる。誰もシード値を最適化することはできないのだ。それは整数であり、そこから「美しい画像」へと至る関数は不連続であり、導関数を持たない。滑らせるための勾配は存在しない。 残された方法はただ一つだ。たくさん生成し、評価し、良いものを残すこと――これは、best-of-nや言語モデルにおけるサンプリング(除去)と同じ系統のものだ。
この作業を迷信から技術へと変えたのが、自動採点システムだ。私の画像生成システムでは、完成した絵ごとにCPU上で2つの安価な指標――ハイライトの割合と全体的な色ずれ――が測定され、閾値を超えた場合はシードを変更して再生成する。これは最大3回まで行われる。 人間が確認する前に、マシンが自動的に不適合な作品を自ら排除する仕組みになっている。
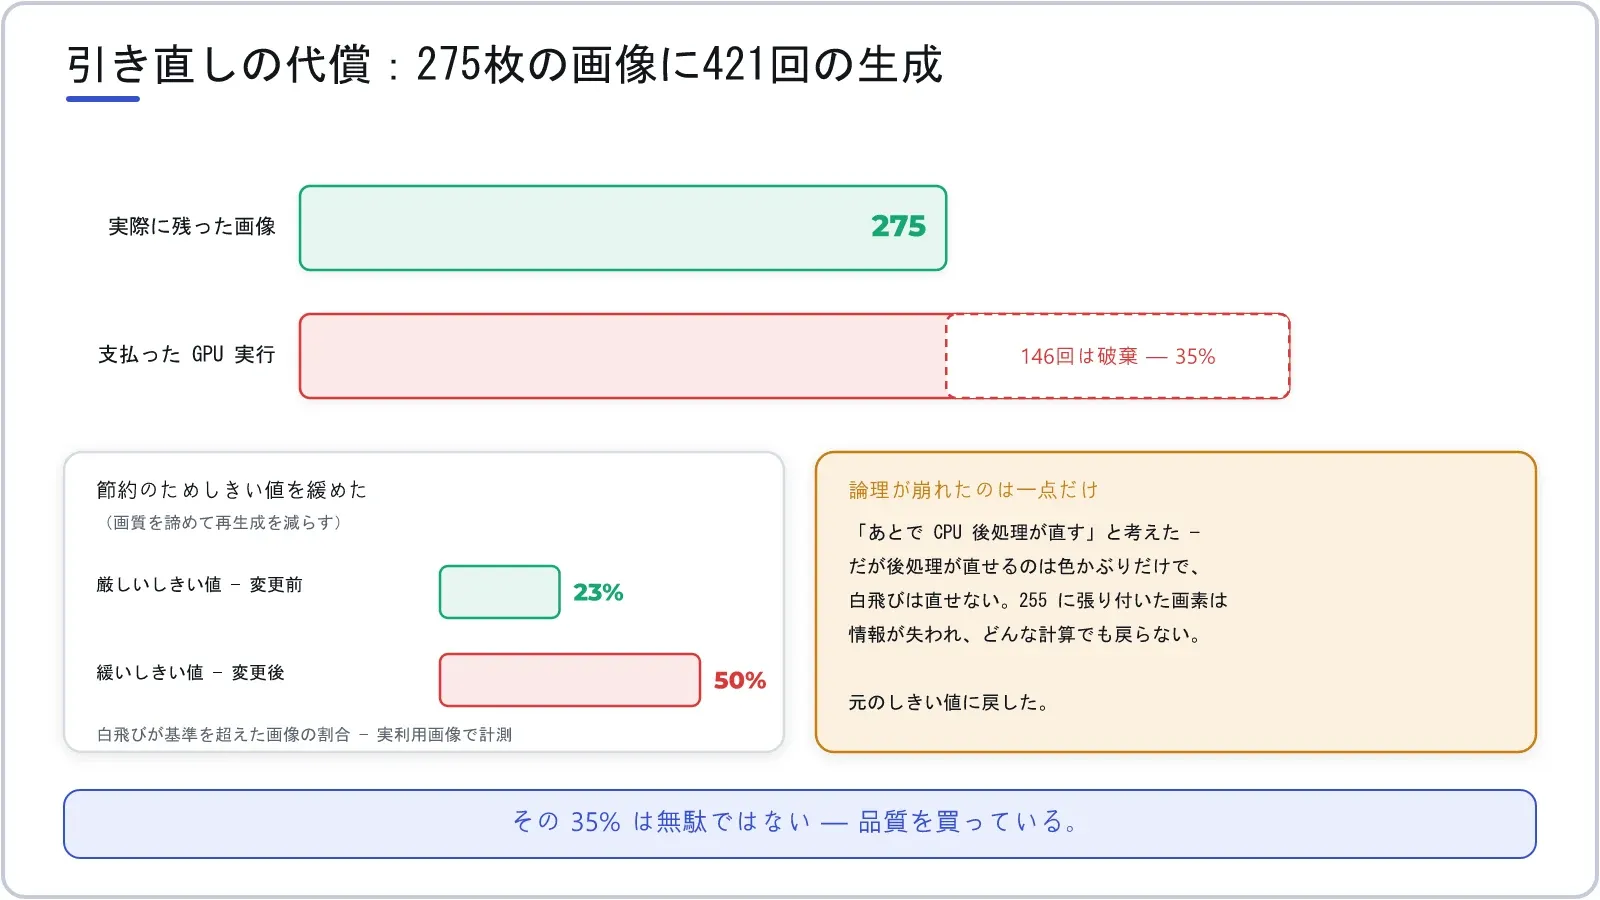
請求書には率直にこう記されていた。保存された275枚の画像を処理するのに421回のGPU描画が費やされた――つまり、処理能力の35%がそのままゴミ箱行きだったのだ。この数字を見て、私は節約の余地を見つけたと思い、再描画の閾値を引き上げた。 その後の測定結果:露出オーバーの画像の割合が23%から50%に増加し、画像ライブラリの管理者は誰に指摘されるまでもなく、すぐにそのことに気づきました。
私の考えは、たった一点だけ間違っていた。つまり、画像を少し焼きすぎてから、CPUでの後処理で修正すればいいと思っていたのだ。 しかし、色かぶりは後処理で補正できるものの、ハイライトの焼き付きは補正できません。255でクリップしてしまったピクセルは情報が完全に失われており、どんな計算をしても元に戻すことはできません。しきい値を元に戻しました。その35%のGPU使用率は無駄ではありません。品質を確保するために使われているのです。
経済コーナー:電気で買う運
再学習を行うたびに、GPUをフル稼働させることになります。つまり、1枚の画像にかかる真のコストは、成功した回ではなく、破棄された回にあるのです。そして、その破棄率はモデルではなく、あなたが設定した閾値によって決まります。そこから3つの金銭的な影響が生じます。
1:採点システムは生成システムよりも高価だ。生成モデルは平均的な品質を決定し、採点システムは、ある閾値を超えるために何回試行する必要があるかを決定する。安価で正確な採点システムなら、すぐに請求額を削減できる。誤った採点システムなら、ゴミとして捨ててしまうか、すでに合格している画像をGPUで再描画することになる。
2つ目:シードを記録し忘れると、すでに購入したものを再度購入することになる。美しい画像があってもシードを保存しておかなければ、それを再び見つけるには手探りで探すしかない――しかし、シードの空間は膨大すぎて、手探りで探すのは無意味だ。メタデータに数値を1つ記録するのはほぼ無料だが、記録しなければ、支払ったGPUリソースのすべてが無駄になってしまう。
第三に、1回の実行だけでモデルを比較するのは、ノイズに賭けるようなものだ。2つのモデル間の差は、同じモデルの2つのシード間の差よりも小さい場合さえある。そのような数値に基づいてインフラの購入を決定することは、データに基づいて購入していると思い込んでいるだけで、実際には運任せの購入に他ならない。
そのコスト構造は、「実行時計算」という名称の下で言語モデルにおいても繰り返されています。すなわち、多くの解を生成し、評価し、最良のものを保持するというものです。 生成回数が増えるにつれてコストは上昇しますが、モデルはパラメータを一切変更しません。したがって、トークン単価は物語の半分に過ぎず、残りの半分は、実用的な結果を得るために何回生成を繰り返さなければならないかという点です。
だからこそ、最も価値のある最適化の方向性は「描き直しを速くする」ことではなく、そもそも全体を書き直さないことなのです。 私のシステムでは、小さな領域を部分的に修正して古い画像の上に重ねるのに1フレームあたり約32~34秒かかりますが、完全に描き直す場合は約50秒かかります。さらに重要なのは、修正範囲外のピクセルは一切変更されないため、もともと良好だった部分を台無しにするリスクがないことです。 画像全体を再描画することは、あらゆる修正方法の中で最もコストのかかる方法です。
真の仕事:偶然をプロセスに変える
まとめると、いわゆる「結果を最適化するAIエンジニア」とは、実は偶然を操ることではない。それは、ごくありふれた5つの習慣である:
- 種子は製品自体に記録し、外部の帳簿には記録しない。ファイルに埋め込まれたメタデータは、いかなる表計算ソフトよりも長持ちする。
- 複数のデータで測定し、中央値を報告すること。最も見栄えの良い結果を報告してはならない――たとえ方法論が不適切であっても、最も見栄えの良い結果は常に存在するからだ。
- テストにシード値を固定しておけば、結果が変わった際に、それが「今日マシンが調子悪かった」のではなく、自分が何かを修正したことが原因だと確実に判断できます。
- 「運が悪かった」と「やり方が間違っていた」を区別すること。10個のシードがすべて同じパターンで失敗した場合は、プロンプト、画像サイズ、パラメータに問題がある。そのまま続けても電気を無駄にするだけだ。
- 良好なシードライブラリと、それに付随する条件(どのモデル、どのサイズ、どのサンプリングセットか)を保持しておくこと。モデルを変更すると、状況が異なるため、そのライブラリ全体の価値は失われる。
ここには心地よい皮肉がある。熟練した職人も、他の人より幸運なわけではない。彼らはただ、自分が幸運だった場所を記憶し、そこに戻れるだけなのだ。足掛かりとなるものなど何もない混沌の中において、それこそが唯一の優位性なのである。
予測
- 再現性のある成果こそが、売れるものとなる。モデルが監査、医療、法務の分野に導入されると、ベンダーは「確定モード」を独自のサービスレベルとして提案してくるだろう――処理速度は遅く、コストは高くなるが、その代わりに再実行すれば以前と全く同じ結果が得られる。
- 「シード」は製品の原点の一部となる。AIが生成した画像やテキストには、再現と証明の両方の目的で、「原材料明細書」として、シード、モデルバージョン、計算パラメータが添付される。
- 自動採点システムは、生成システムよりも多くの投資を集めるだろう。すべてのユーザーがいくつかの基盤モデルを共有するようになれば、差別化の要因となるのは、どれだけ巧みにフィルタリングできるか、そして満足のいく結果を得るために何回実行にコストを投じるかということになる。
- 複数のシードを報告することが、最低限の要件となるだろう。1回の実行だけでモデルを比較することは、ソフトウェア業界が1回のタイム測定による性能評価という慣習を捨てたのと同様に、徐々に「使い物にならないデータ」と見なされるようになるだろう。
- 部分的な修正が、再生成に取って代わっていく。破損した領域だけを修正する方が、フレーム全体を描き直すよりも安価で安全だ。「ここが気に入らない」という部分を修正が必要な領域に変換できるツールが、修正需要の大部分を占めるようになるだろう。
- しかし、ノイズは依然として存在します。生成がランダムな起点から始まる限り、生成と選択という作業は残ります――ツールは単に生成を安価にし、選択をより賢明にするだけなのです。
Thảo luận