更新:2026年9月。
2026年9月1日、Anthropicは「Claude Fable 5.1」とその双子の兄弟である「Claude Mythos 5.1」を発表した。プレスリリースではベンチマークについて触れられているが、それとは別に注目すべき点が2つある。 第一に、トークン単価は1セントも変わっておらず――入力100万トークンあたり10ドル、出力100万トークンあたり50ドルのまま――であるにもかかわらず、同社は請求額が約4分の1に減少したと発表している。 第二に、その技術ノートには「エラー400を返す」という文言で始まる行が数多く見受けられる。
この2つの点こそが、ベンチマーク結果以上にこのモデルについて多くを物語っている。この記事では、Fable 5.1をそのAPIそのものを通じて分析している――なぜなら、排除された機能の一つひとつが設計上の決定であり、設計上の決定こそがプレスリリースよりも正直だからだ。
1つのモデル、2層の保護
まず明確にしておくべき点:Fable 5.1とMythos 5.1は同一のモデルである。Anthropic社自身によると、両者の違いは安全バリアのレベルにあるだけだ。 Fable 5.1は一般に公開されていますが、Mythos 5.1は「信頼できるアクセスプログラム」を通じてのみユーザーに提供されており、サイバーセキュリティおよびライフサイエンス分野向けに特別に設計された安全対策が施されています。
これは注目すべき区分であり、単なる技術的な問題ではありません。同社は「能力」と「権限」を切り離そうとしているのです。同じ重み付けであっても、誰が何ができるかは、そのユーザーが認証済みかどうかによって決まります。 以前は、その境界線はモデル内部にありました――強力なモデルには厳重な障壁が伴い、正当なユーザーも悪意のあるユーザーと同様に誤検知による制限を受けることがありました。現在、その境界線は外部へと押し出され、身元確認と契約の問題となっています。
仕様表の残りの部分:モデルID claude-fable-5-1、100万トークンのコンテキストウィンドウ(最大値はデフォルト値と同じ)、最大出力12万8千トークン、Amazon Web Services、Google Cloud、Microsoft Azureを含むすべての主要プラットフォームで利用可能です。
数字の表を正しく読み取る
Anthropicは一連のスコアを発表した。 しかし、よく読むと、同世代のモデルとの比較基準が併記されて公開された測定値は、Terminal-Bench-Science 0.1のたった1つだけであり、そこではFable 5.1が52.6%を記録したのに対し、Fable 5は24.7%にとどまり、2.1倍の差がついた。
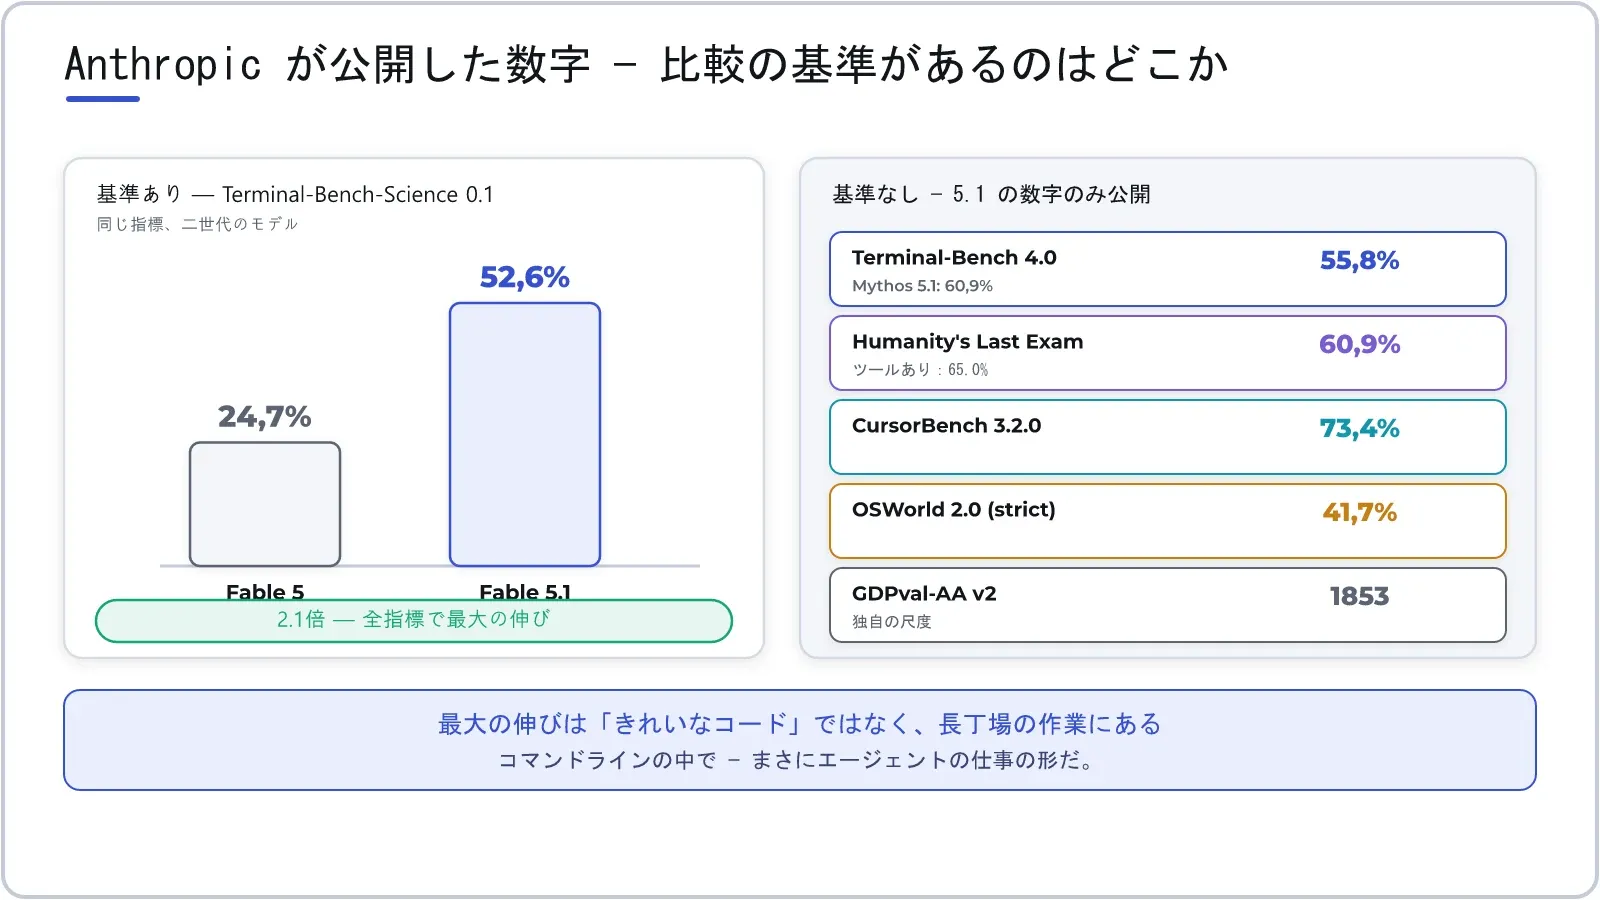
その他の数値は、Terminal-Bench 4.0が55.8%(Mythos 5.1版は60.9%)、Humanity’s Last Examはツール未使用時で60.9%、使用時で65.0%、 CursorBench 3.2.0は73.4%、OSWorld 2.0の厳格なバージョンでは41.7%、GDPval-AA v2は1853——これらはすべて新バージョンの数値のみが記載されている。 これらはモデルがどれほど強力かを示していますが、どれほど進歩したかは示していません。これらは異なる2つの問いであり、これらを混同することは、プレスリリースを誤読する最も簡単な方法です。
このランキングが実際に示しているのは、最大の飛躍がどこで起こったかという点にある。つまり、これはコマンドライン環境での長期的な作業能力を測る指標であり、美しいコードを書く能力を測るものではない。 まさにそれがエージェントの仕事のあり方だ――曖昧な目標を受け取り、シェル環境の中で手探りで進み、間違えば自分で修正し、誰にも手取り足取り教わることなく何十回も実行を繰り返す。
科学的な側面では、同社はスコアに代わる2つの具体的な例を挙げている。タンパク質設計における約50%の成功率と、詳細度が2~3km向上した金星の表面標高マップである。 これらは点数ではなく製品によって測定される結果であり、同時に独立して検証するのが最も難しい種類の結果でもある。
方法論に関する注意点として、模型レースに関するこの記事の趣旨に則り、上記の数値はすべてメーカー自身が公表したものです。これらは参考になりますが、実際の作業における測定結果に代わるものではありません。
思考はもはやスイッチではない
ここからAPIが率直に語り始めます。Fable 5.1では、思考機能は常にオンになっており、オフにすることはできません。送信 thinking: {type: "disabled"} すると400エラーが発生します。従来の形式で送信する budget_tokens —つまり、モデルが処理するためのトークン予算を事前に設定する—場合でも、エラー400が発生します。
その代わり、本質的に全く異なるパラメータが設けられています: effort、「low」から「max」までの5段階のレベルです。違いは構文にあるのではなく、誰が推測しなければならないかという点にあります。トークン予算では、問題がどれほど難しいかを事前に推測し、それに応じた分だけ割り当てなければなりません――推測が足りなければモデルは途中で中断され、推測しすぎれば使わなかった分まで支払わなければなりません。一方 effort 単に「どこまで頑張るか」を指定し、モデルが各ステップごとに自動的にリソースを割り当てるようにする。問題がどれほど難しいかを知っているのは、それを解いている本人であり、注文した人ではない。
「粗い推論チェーン」は、どのような設定であっても決して返されることはありません。選択できるのは表示方法のみです。デフォルトは「空白」、`summarized` は読みやすい要約を返し、`updates` — 今回のバージョンで新たに追加された機能 — は、ツールが呼び出される合間にモデルが書き込んだ短い進捗メモを返します。
この3つ目の選択肢は、非常に現実的な問題から生まれたものです。つまり、難しい問題の処理には数分かかることがあるからです。 ユーザーインターフェースの観点から言えば、数分間の無反応は、システムがフリーズした状態と見分けがつきません。したがって、実際に人が待機する用途にこのモデルを採用する場合は、データフローと待機時間について一から再検討する必要があります。これはもはや「2秒で応答する」モデルではないのです。
このノートはページをちぎってはいけません
そして、これが最も目立たない変化ですが、エージェントを構築している人にとっては最も重要な変化です。
Fable 5.1では、思考ブロックは、それらが生成された正確なモデルおよび会話履歴内の正確な位置にしっかりと結び付けられています。 過去のターンを修正すると、その後に続く思考ブロック全体が無効になります。2026年8月31日以降に開設されたアカウントでは、これは警告ではなく、即座にエラー400として処理されます。Anthropicはこの仕組みを「preserved thinking(保存された思考)」と呼んでいます。
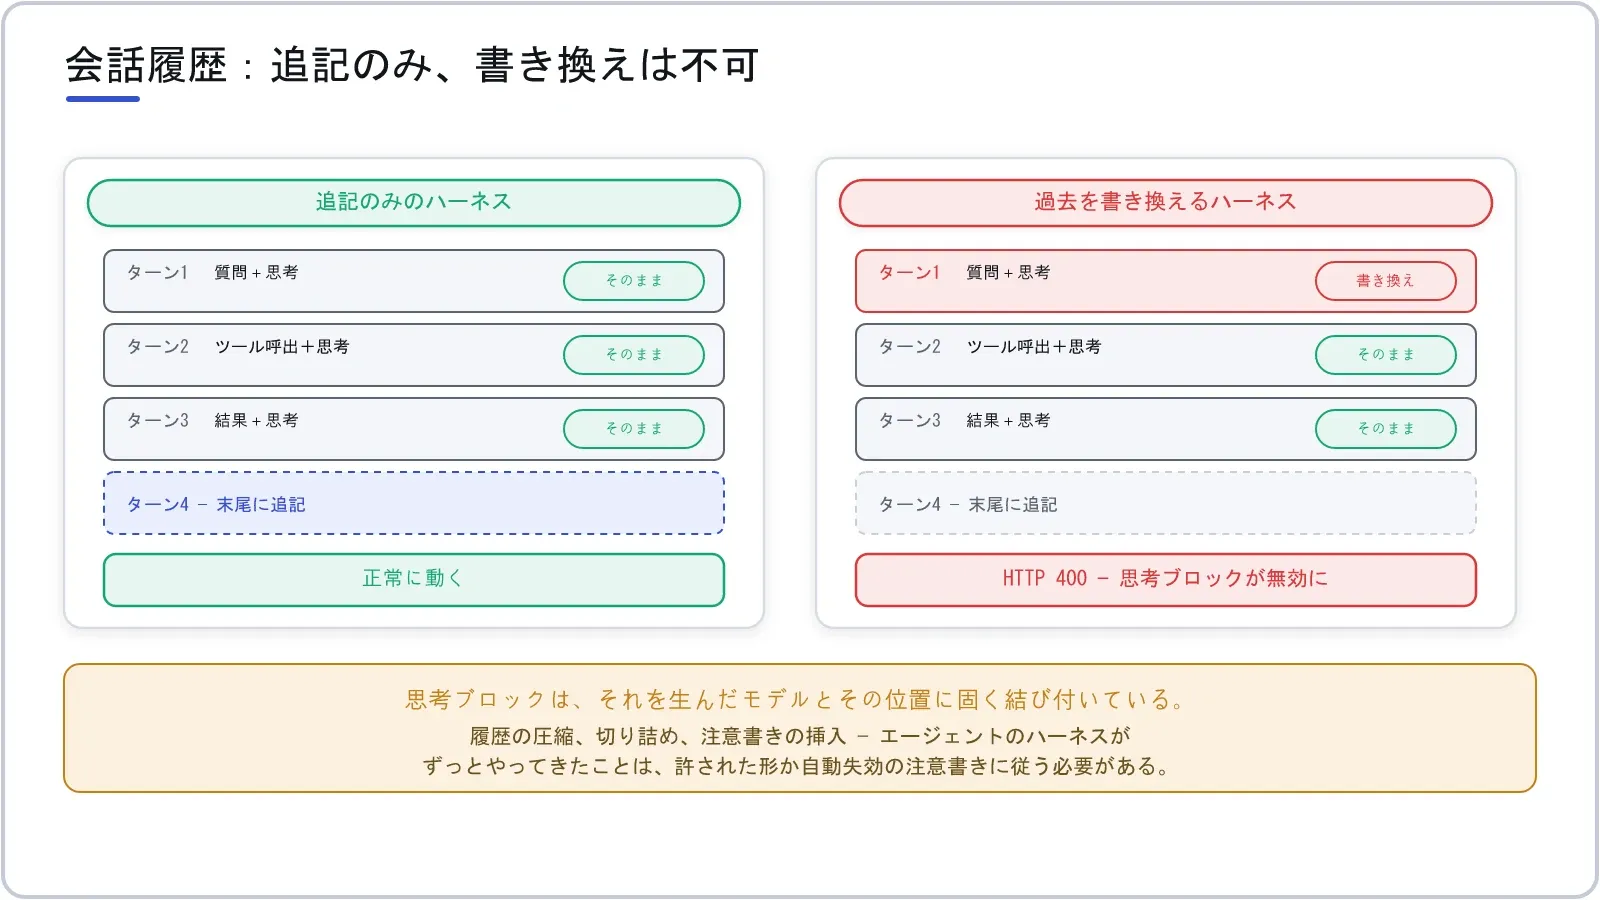
なぜこれほど重くなるのかを理解するには、従来のエージェントフレームワークが会話履歴に対して何を行ってきたかを思い出す必要がある。つまり、自由に書き換えていたのだ。 文脈情報を節約するために古い部分を圧縮する。ツールの長い出力を切り詰める。途中にリマインダーの一行を挿入する。古い質問を簡潔に書き直して、そのすべてを再送信する。これらすべての処理は、誰も口には出さないある前提に基づいている。つまり、「過去は下書きであり、いつでも修正できる」という前提だ。
Fable 5.1 はその前提を捨てました。過去は今や証拠であり、下書きではありません。フレームは「追加のみ」のフレームにならなければなりません。新しいものはすべて最後に追加され、例外はありません。各ターンでモデルに何を通知したい場合は、自動消滅するシステムメッセージ(clear_at: "next_user_message")を使用してください。これは一度だけ正しく表示された後、自動的に非表示になるため、古いものを手動で削除する必要がありません。また、履歴を圧縮する場合は、許可された形式に従って圧縮し、勝手に切り貼りしてはいけません。
広い視野で見れば、これは私が「種」に関する記事で書いた内容と同じ流れにある。つまり、再現可能な結果が徐々に「売れるもの」になりつつあるのだ。「これがまさにあの答えへと至った推論の連鎖であり、その過程で誰も手を加えていない」ことを証明できるモデルは、監査にも活用できる。 その代償として、フレームワークを作成する者の自由が制限されることになる。
その他の2つの箇所:「ツールの呼び出し」と「断りの言葉」
ツールの強制呼び出しは廃止されました。旧方式(モデルに特定のツールの呼び出しを強制するもの)は、現在400を返します。その真の目的を見れば、理由は明らかです。多くの場合、ツールが強制呼び出しされるのは、所定の形式のJSONデータブロックを取得するためだけだったからです。 現在、そのためのより直接的な方法があります。 strict を有効にしてパラメータを常に有効な状態に保つか、構造化された出力を利用します。正式な方法が用意されたため、このショートカットは廃止されました。
拒否は、処理すべき状態となります。安全分類モジュールがリクエストをブロックした場合、APIはエラーを返さず、HTTP 200ステータスコードと stop_reason: "refusal" 分類コードを返します。つまり、事前にチェックを行わずにコンテンツをそのまま読み取るコードは stop_reason 空の文字列を読み取り、その理由を理解できなくなる。その代わり、新たな安全弁が設けられている。fallbackを宣言しておけば、拒否された際にAPIは同じ呼び出し内でそのリクエストを別のモデルで自動的に再実行し、文字列が生成される前に発生した拒否は課金対象外となる。
この点をプレスリリースにある数値と照らし合わせると、全体像が見えてきます。Anthropic社によると、Claude Codeのユーザーは、Fable 5と比較して、1セッションあたりのサイバーセキュリティ対策による介入回数が約60%減少するとのことです。また、このモデルはソフトウェアの脆弱性発見にも使用が許可されています。 これは同じ事柄の2つの側面です。適切な箇所で規制を緩和しつつ、誤検知によるブロックが発生した場合の回避策を事前に用意しておくことです。誤検知は、正当なユーザーがセキュリティ対策に対して支払わなければならない「代償」のようなものです。その「代償」を軽減することは、単なる宣伝文句ではなく、真に実用的な機能なのです。
経済コーナー:コスト削減の鍵はキャッシュにある
記事の冒頭で触れたパラドックスに戻ろう。トークンの購入価格と売却価格は変わらない。変わるのは、キャッシュから読み取られる価格だ。それは75%も安く、100万トークンあたり0.25ドルになっている。
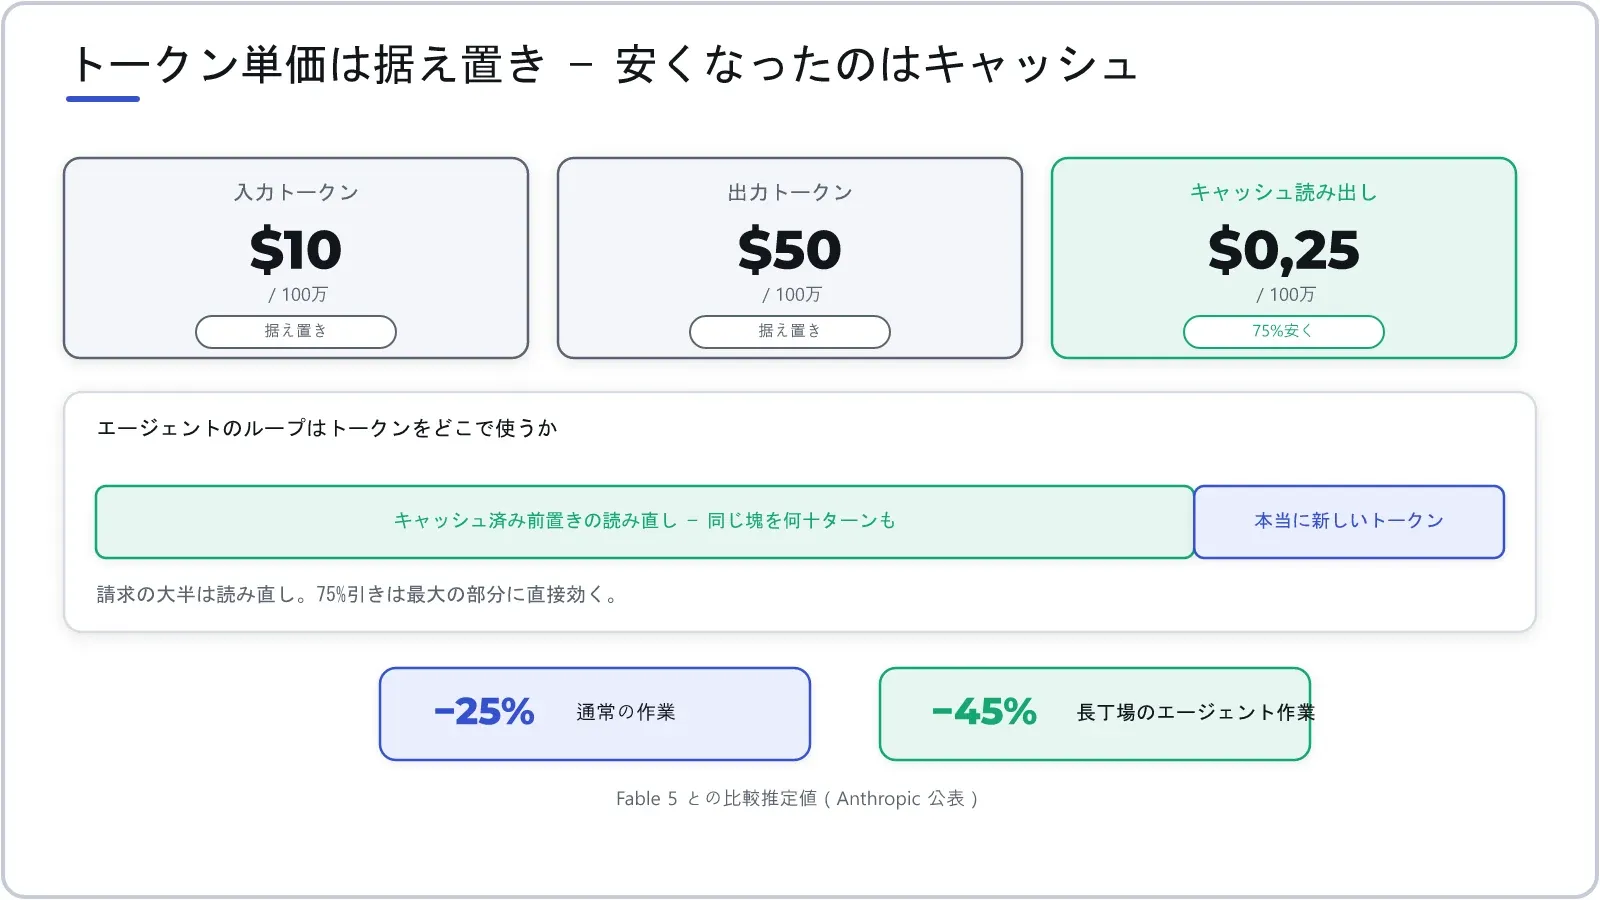
なぜ、これほど些細な変更で請求額を4分の1も削減できたのでしょうか?それは、エージェントのループにおいて、支払いの対象となるトークンの大部分が新しいトークンではないからです。エージェントが20回実行されるたびに、ほぼ同じプレフィックス――システムの説明、ツール一覧、初期からの履歴――が20回も再送信されるのです。 各ターンで新たに生成される部分はほんの一部に過ぎません。再読み込みにかかるコストを削減することは、請求額の最大部分を削減することになります。これが、同社が通常の場合で約25%、長期にわたるエージェントの場合は最大約45%の節約を見込んでいる理由でもあります。
そこから、3つの実用的な帰結が導き出される。
第一に:プレフィックスを安定させておくこと。これが、今やあなたが持つ最も安価なレバレッジだ。プレフィックスに依存するキャッシュ――先頭の1バイトが変更されると、その後の部分がすべて無効になってしまう。 システム記述内の1つのタイムスタンプ、固定されていないソート済みツールリストがあれば、各イテレーションで完全な代償を払うのに十分です。以前は、このエラーにはコストがかかりましたが、今では失う部分が4分の1の価値しかなくなったため、そのコストははるかに高くなっています。
2:effortは2つ目のコスト調整ノブであり、これは事実です。同じモデルにおいて、努力レベルを下げると、トークンの消費、ツール呼び出し回数、プロンプトの数が減ります。分類や短いQ&Aの場合、レベルを低く設定しても特に損失はありませんが、長期的なプログラミングでは、レベルを上げる方が価値があります。
3:通話1回ごとではなく、「完了したタスク」1件ごとのコストを測定すること。Fable 5.1はOpus 5の2倍——10/50ドル対5/25ドル——、Sonnet 5の5倍のコストがかかります。 1回の通話あたりの料金は安くても、タスクを完了させるのに3回も通話しなければならないなら、決して安くはない。これこそが唯一意味のある比較であり、また、あなた自身のデータによってのみ答えが得られる比較でもある。価格表の数字が、実際に支払う金額ではない理由を理解するには、トークンごとの価格決定アルゴリズムに関する記事も参照してほしい。
最後に、金銭では測れない2つの条件がありますが、これらが障害となる可能性があります: Fable 5.1では30日間のデータ保存が義務付けられています。データ保存を行っていない組織は、Anthropicから個別に許可を得ない限り、即座に利用を拒否されます。また、Priority Tier(優先利用枠)が存在しないため、システムが混雑している際に優先利用枠を購入することはできません。
予測
- 「単に追加する」ことが、すべてのエージェントフレームワークのデフォルトとなるだろう。ある大手プロバイダーが履歴の書き換えをハードエラーとしたとき、ライブラリもそれに追随するだろう――そして、文脈を勝手に切り貼りするという習慣は、一時的な過渡期として記憶されることになるだろう。
- 価格競争の焦点は、トークンからキャッシュへと移行した。トークン単価は2世代連続で横ばいである一方、再読み取りコストは75%低下した。価格競争は「既知の情報を再読み取りする」部分で繰り広げられることになるだろう。なぜなら、そこにこそ真の処理量が存在するからだ。
- その努力の度合いは、エンドユーザーにも明らかになるだろう。今日
effortはプログラマーのパラメータですが、まもなくユーザーがインターフェース上で「即答」か「熟考(より高価)」を自ら選択できる製品が登場するでしょう。 - FableとMythosの区分方法は模倣されるだろう。権限から能力を切り離す――同じモデルでありながら、ユーザーが検証した内容に応じて障壁が異なる――という仕組みは、あらゆる研究所が直面しているジレンマを解決するものであり、単一の企業が単独で実現するのは難しい。
- コンテンツの起源は、機能から契約条項へと移行するだろう。モデルによって生成されたコンテンツにタグ付けが可能になれば、規制のある業界の買い手は、単に利用可能な場合に使用するだけでなく、そのタグを要求し始めるだろう。
- しかし、自己申告による評価基準だけでは依然として不十分です。一連の測定値のうち、同世代の比較基準を持つものが1つしかない限り、真剣な買い手は自社の業務に基づいて独自の測定基準を構築せざるを得ません。そして、それがこの一連のプロセスの中で最も労力を要する作業であり続けるのです。
Thảo luận