更新日:2026年9月。
この2つの文は、私の資料庫から引用した実際の翻訳結果です:
- OnlyOffice → 「Only Mohammad」
- 「BỘ SINH SỐ」 → 「DEPARTMENT OF BIOMATICS」
どちらも機械翻訳です。しかし、これらは異なる2つのサービスによるものであり、さらに重要なのは、その原因がまったく異なるということです。一方はサービスを切り替えることで解決できますが、もう一方は何度切り替えても同じ結果になります。
この記事では、230本以上の技術記事を3つの言語に翻訳した経験から得られた知見——何がうまくいかなかったか、その原因、そして実際に効果のある解決策——についてまとめました。
2つの故障パターン――間違った対処法は避けること
ケース1:翻訳すべきでないものまで翻訳してしまう。私が最初に試したセルフホスト型の翻訳ツールは動作は非常にスムーズだったが、固有名詞を一般的な単語として扱ってしまった。「OnlyOffice」が「Only Mohammad」になってしまった。 Photoshopは「Bristol」となってしまいました。技術文書においてこれは致命的なミスです。なぜなら、固有名詞こそが読者が照合する対象であり、ソフトウェア名の翻訳が間違っていると、その文全体が意味をなさなくなってしまうからです。
ケース2:意味を推測するのに十分な文字数がありません。私が利用している最高の商用サービスは、固有名詞の扱いが完璧で、文章の翻訳も滑らかですが、2~3文字のラベルに遭遇すると、「DEPARTMENT OF BIOMATICS」のようなものをでっち上げてしまいます。私のデータセットには、他にもいくつか異例の例があります:
- 「SỐ HẠT GIỐNG」 →「NUMBER OF SEEDS」(種子の数 — 本来は種子の価値を指す)
- 「nhận mẫu」 →「select font」(「mẫu」をフォントと解釈している)
- 「tiền huấn luyện」 → 研修費用(「tiền」を「お金」と解釈しており、接頭辞としての「tiền-」の意味ではない)
- 「token nạp vào」 → 日本語の「入金」、つまり口座への入金
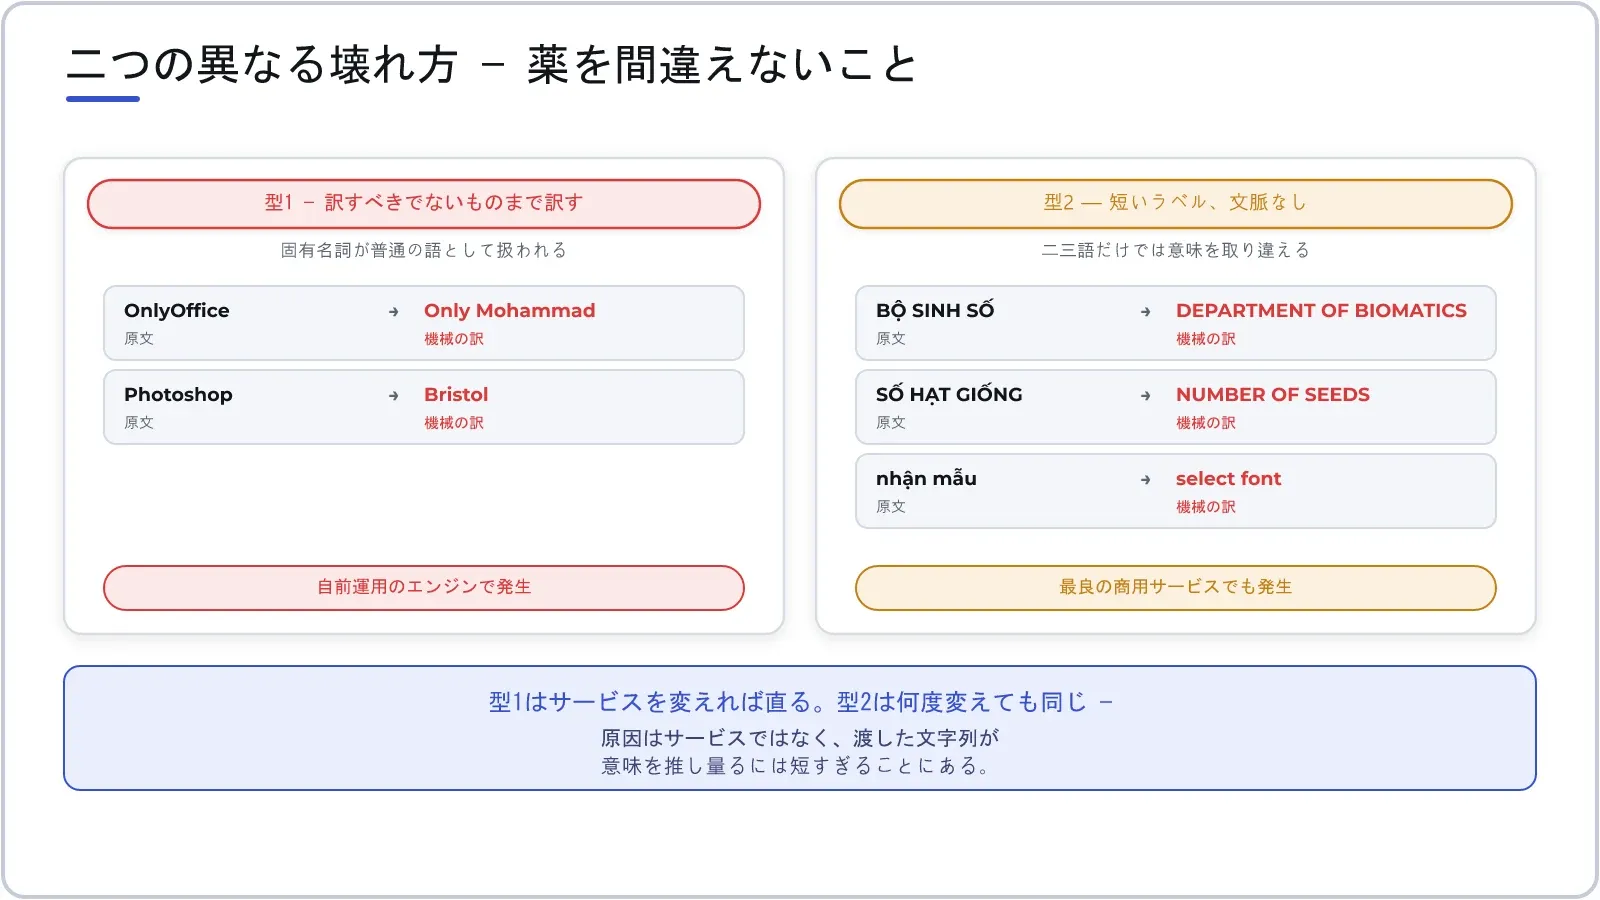
そのリストを見ると、ある法則が見えてくる。この機械は文法的には間違っていないが、「意味」を間違えている――しかも、ベトナム語に同音異義語があり、文脈によってのみ区別できる箇所で、まさにその通り間違っているのだ。しかし、2、3文字のラベルに文脈などあるはずがない。
なぜ固有名詞の「保護カバー」が壊れてしまうのか
最初の不具合の場合、自然な反応として、名前を入力する前に保護措置を講じることになります。私は2つの方法を試してみましたが、どちらも失敗に終わりました。私のように時間を無駄にしないよう、ここに記録しておきます。
方法1 — 固有名詞をプレースホルダー(例: XKEEP0X)に置き換え、翻訳が終わったら元に戻す。結果:機械が文の半分を飲み込んでしまった。そのプレースホルダーは機械にとって意味をなさないため、残りの部分を不完全な文として扱い、勝手に切り捨ててしまった。
方法 2 — 固有名詞を<code>タグで囲み、システムがそれをプログラミングコードと認識して無視するようにする。結果:固有名詞は正しく保持されるが、その周囲の文法が断片化され、文章が途切れたように聞こえる。
この2つの事例から得られる共通の教訓は、入力列に介入することは、機械が文法を推測するために用いるものそのものに介入することだということだ。文の一部を取り除けば、その先で文を再構築するために必要な手がかりも同時に奪ってしまうことになる。
実際の解決策は、むしろ退屈なほど単純です。サービスを変えるだけです。商用サービスは最初からその名称を隠すことなく、そのままの形で提供されています。言い換えれば――「どれほど魅力的か」という長所ではなく、「我慢できない短所」に基づいてツールを選ぶべきなのです。
言葉は流れ去り、ラベルは破れた
商用サービスに移行した後、図解に含まれる文字セットを正確に測定したところ、ある法則がはっきりと浮かび上がりました:
- 完全な文:翻訳が良好。図表内の長い文や本文全体の散文も、読みやすい翻訳となっており、専門用語も正しく使用されており、修正の必要はない。
- 2~3文字の短いラベル:頻繁に誤りが見られる。特に大文字で書かれたラベルは、大文字にすることで品詞の手がかりまで失われてしまうため、問題となる。
これは知っていれば当然のことのように聞こえますが、一般的な習慣を覆すものです。多くの人は、手間を省くために、ラベルだけを別のファイルに抜き出し、そのファイル全体を翻訳ツールに投入しがちです。しかし、その「手っ取り早さ」こそが品質を損なう原因となります――そうすることで、個々の文字の文脈を完全に切り離してしまうからです。
どうしてもラベルを個別に翻訳しなければならない場合は、2つの方法があります。文脈を1文添えるか、あるいは翻訳ツールによる翻訳を控えるかです。
上書き辞書:最も安価な解決策
2つ目の方法は私が現在使っているもので、驚くほど安いです。その仕組みはたった一言で説明できます。「翻訳ツールを呼び出す前に、自分で書いた辞書を調べてみる。もし載っていればそれをそのまま使い、載っていなければその時に初めて翻訳ツールを呼び出す」というものです。
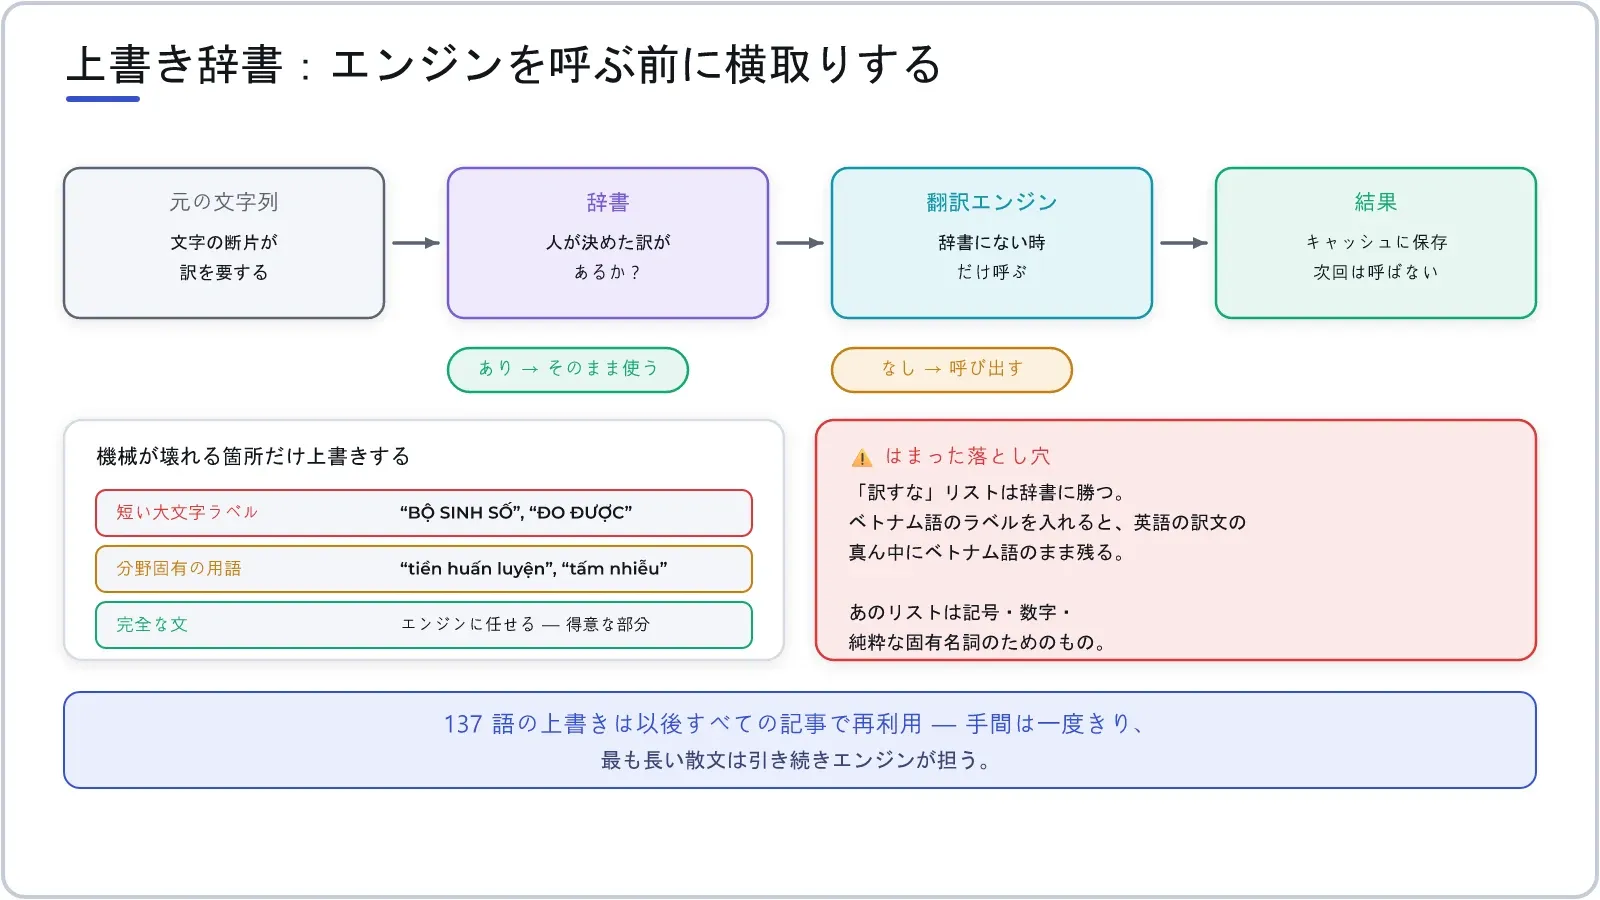
重要な点は、資料全体を手作業で翻訳する必要がなく、機械が誤訳しがちな箇所だけを正しく修正すればよいということです。現在、私の辞書には137のフレーズが収録されており、そのほとんどが短いラベルや業界固有の用語です。 最も長い部分、つまり散文は、引き続き機械に任せます。そして、その137のフレーズは以降のすべての記事で再利用可能です。一度の労力で、その価値は永続的に積み重なっていくのです。
現在、ほとんどの商用サービスでは、この機能が「用語集」という名称で提供されています――しかし、自分で作成する場合であっても、それは単なる参照表であり、「該当する場合は使用する」という指示に過ぎません。
ある罠に引っかかってしまったので、他の人も引っかからないよう記録しておく:お使いのツールに「翻訳しない」リスト(コード、記号、固有名詞などを原文のまま残すためのもの)がある場合は、そのリストが辞書よりも優先されるかどうかを確認してください。私の場合はそうでした。 念のため、ベトナム語のラベルを「翻訳しない」リストに追加してみたところ、結果としてそのラベルが英語版の中でそのままベトナム語のまま残ってしまいました。「翻訳しない」リストには、記号、数字、および純粋な固有名詞のみを含めるべきです。
図中の文字こそが重要な部分だ
資料に図やグラフ、注釈付きのスクリーンショットが含まれている場合、その部分の翻訳には、文章全体の翻訳をすべて合わせたよりも多くの手間がかかります。翻訳が難しいからではなく、翻訳文は分量が増えるのに対し、元の枠組みは変わらないからです。
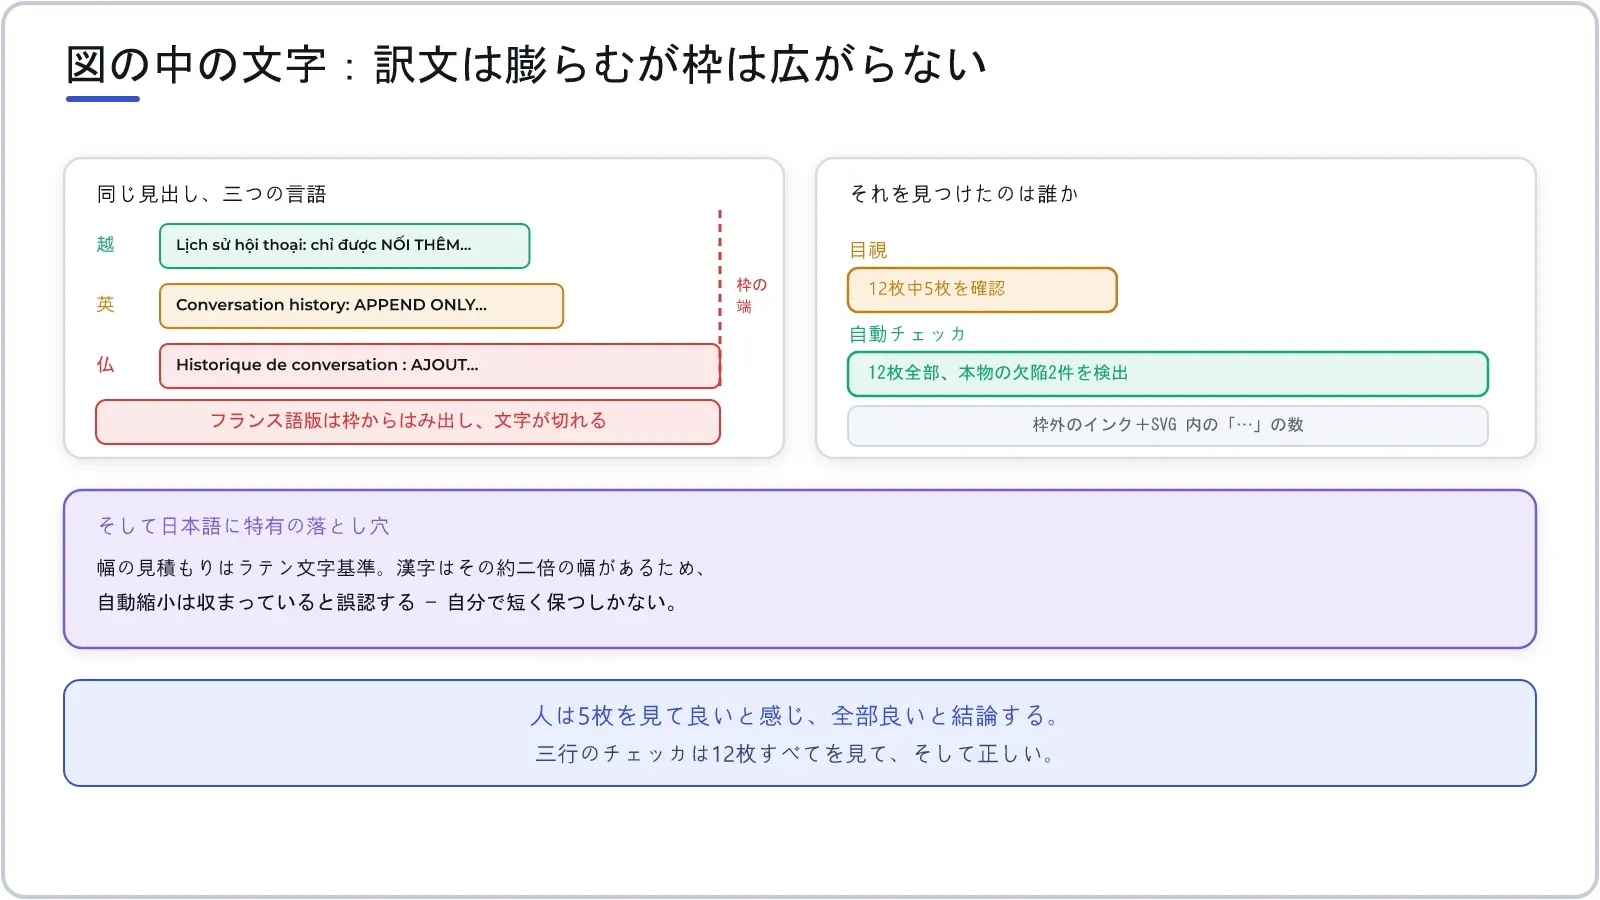
私が先ほど作成した図表を実際に測定してみると、同じ見出しであっても、英語版はベトナム語版より約10分の1長く、フランス語版は3分の1も長い。そのフランス語の見出しは写真の端からはみ出して切り取られてしまっているが、ベトナム語版と英語版はちょうど収まっている。
日本語には逆の落とし穴がある。文字数が少ないため、文字数に基づいて幅を推定する関数はすべて、文字列が短いと誤認してしまう――一方で、漢字1文字の幅はラテン文字の約2倍もあるのだ。そのため、文字サイズを調整する関数は幅を縮めず、文字が枠からはみ出しても誰も気づかない。
解決策は2つの部分から成ります。1つ目は、すべてのラベルが枠からはみ出した場合に文字サイズを自動的に縮小させることです。共通関数で修正すれば、ドキュメント全体にその変更が反映されます。2つ目、そしてこれが特に重要な点ですが、自動チェック機能を作成することです。
私のチェック手順は、たった3つのポイントだけでした――枠線からはみ出したインクの線がないか確認し、SVGファイルに自動トリミング機能によって生成された「…」マークが含まれていないか数えること。結果として、12枚のうち5枚を目で確認し、問題がないと判断したので、投稿しようと思いました。 チェックツールが12枚すべてを処理した結果、私が目視で確認した範囲外にある2枚の不具合を検出しました。
この経験から私が最も長く心に留めている教訓は、次の通りです。人は5枚の写真をみて「これらは美しい」と感じ、そこから「この一連の写真もすべて美しい」と結論づけてしまうものです。多言語の資料において、読めない言語こそが、最も表面的にしか理解できていない言語なのです。
経済コーナー:「無料」という言葉の真の代償
3つの選択肢、3つの値引き方法。
セルフホスト型の翻訳ツールでは、翻訳費用はかかりません。しかし、RAMを消費し、処理に時間がかかり、そして――前述の測定結果からもわかるように――その代償として品質が低下します。すべての固有名詞を手作業でチェックしなければならないからです。製品名が密集している技術文書の場合、翻訳作業よりも修正作業の方が多くなってしまいます。 これはまさに、サービス自ホストに関する記事で述べられたトレードオフそのものであり、ただ今回は、その代償が校正に費やす時間として支払われるという違いがあるだけです。
商用サービスの無料プランでは、通常、毎月約100万文字まで利用可能です。 抽象的な数字に聞こえるかもしれませんが、私の資料庫から具体的な数値に換算してみましょう。2,600語程度の記事1本を3か国語に翻訳すると、約4万文字になります。つまり、1か月に25本ほどの記事を、一切費用をかけずに投稿できる計算になります。 個人のブログであればこれでも十分すぎるほどですが、製品ドキュメントチームにとっては1週間で使い切ってしまう量です。
有料プランは文字数制で計算されますが、ここが最も計算を間違えやすい部分です。比較すべき数字は、100万文字あたりの単価ではなく、翻訳費用と修正にかかる時間の合計です。 請求額こそ高くても、固有名詞を正確に保持してくれるサービスの方が、手作業によるチェックという工程が不要になるため、結果的にははるかに安くなる可能性があります。これは、1回の呼び出しごとではなく、1件の完了ごとのコストで計算されるのと同じ仕組みです。同様の「表示価格の落とし穴」については、クラウドストレージプランの比較記事もご参照ください。
そして、あまり考慮されない資産があります。それは、上書き辞書というもので、時間の経過とともに価値が高まるものです。今日の137のフレーズは、数ヶ月後には200のフレーズになり、それぞれのフレーズはそれ以降のすべての記事で再利用されます。 また、これはプロセス全体の中で唯一、利用しているサービスに依存しないものです。プロバイダーを変更しても、辞書はそのまま引き継がれます。
独自の翻訳システムを構築しようとしている場合でも、オープンソースソフトウェアを導入する前に確認すべき5つの質問はそのまま当てはまります。そして、ここで最も重要なのは、保守コストに関する質問です。
予測
- 用語集のオーバーライド機能は、もはや高度な機能ではなく、必須のものとなるでしょう。あらゆるサービスが同等の品質で文章を翻訳できるようになれば、品質を差別化できる唯一の要素は、各組織固有の専門用語だけになります。
- 画像内の文字の翻訳は、最初から自動化されるようになるでしょう。現在、誰もがまずテキストを翻訳してから、画像があることに気づくのが常ですが、この2つの作業を統合し、さらに文字をフレームに収まるように自動調整できるツールが、多言語ドキュメントの需要の大部分を占めるようになるでしょう。
- 自動チェック機能は、スペルチェックのように翻訳プロセスに組み込まれることになる。これは翻訳の品質を評価するためではなく、枠からはみ出し、文字が切れていたり、未翻訳の文字列が残っていたりするといった機械的なエラーを検出するためである。
- オンプレミス型の翻訳ツールにも依然として役割はありますが、それは別の場面での話です。データが端末外に出せない場所——医療記録や契約書など——では、品質が多少劣っても許容できる代償となります。一方、公開文書に関しては、それを利用する理由は次第に薄れつつあります。
- しかし、人間による校正という工程は消えることはない。機械の翻訳が流暢になればなるほど、誤りは見つけにくくなる。文法は正しくても意味が間違っている文は、文が途切れている文よりもはるかに危険だ。その言語に精通した人間が読み直す必要は依然としてあり、自動校正ツールは、機械が検出できる部分について、人間が個別にチェックする手間を省くのに役立つだけである。
Thảo luận