Mise à jour : septembre 2026.
Dans ma galerie d’images, il y a deux images côte à côte. Même modèle, même prompt jusqu’à la virgule près, même nombre d’étapes, même ensemble d’échantillons, tout ce qui est indiqué dans le tableau des paramètres est identique. L’une est utilisable, l’autre est bonne à jeter. La seule différence réside dans un nombre entier dissimulé dans les métadonnées — ce que les spécialistes de l’IA appellent une « graine » (seed).
Pour un novice, cela ressemble à un détail technique insignifiant, un bouton « aléatoire » sur lequel on appuie pour s’amuser. Les professionnels, eux, savent qu’il a plus d’importance que la plupart des mots contenus dans la consigne. Et tout un mode de fonctionnement s’est développé autour de ce chiffre : comment rendre le hasard reproductible, comment passer d’un coup de chance à un coup de chance encore plus grand, et comment payer la facture d’électricité lorsque la chance tourne.
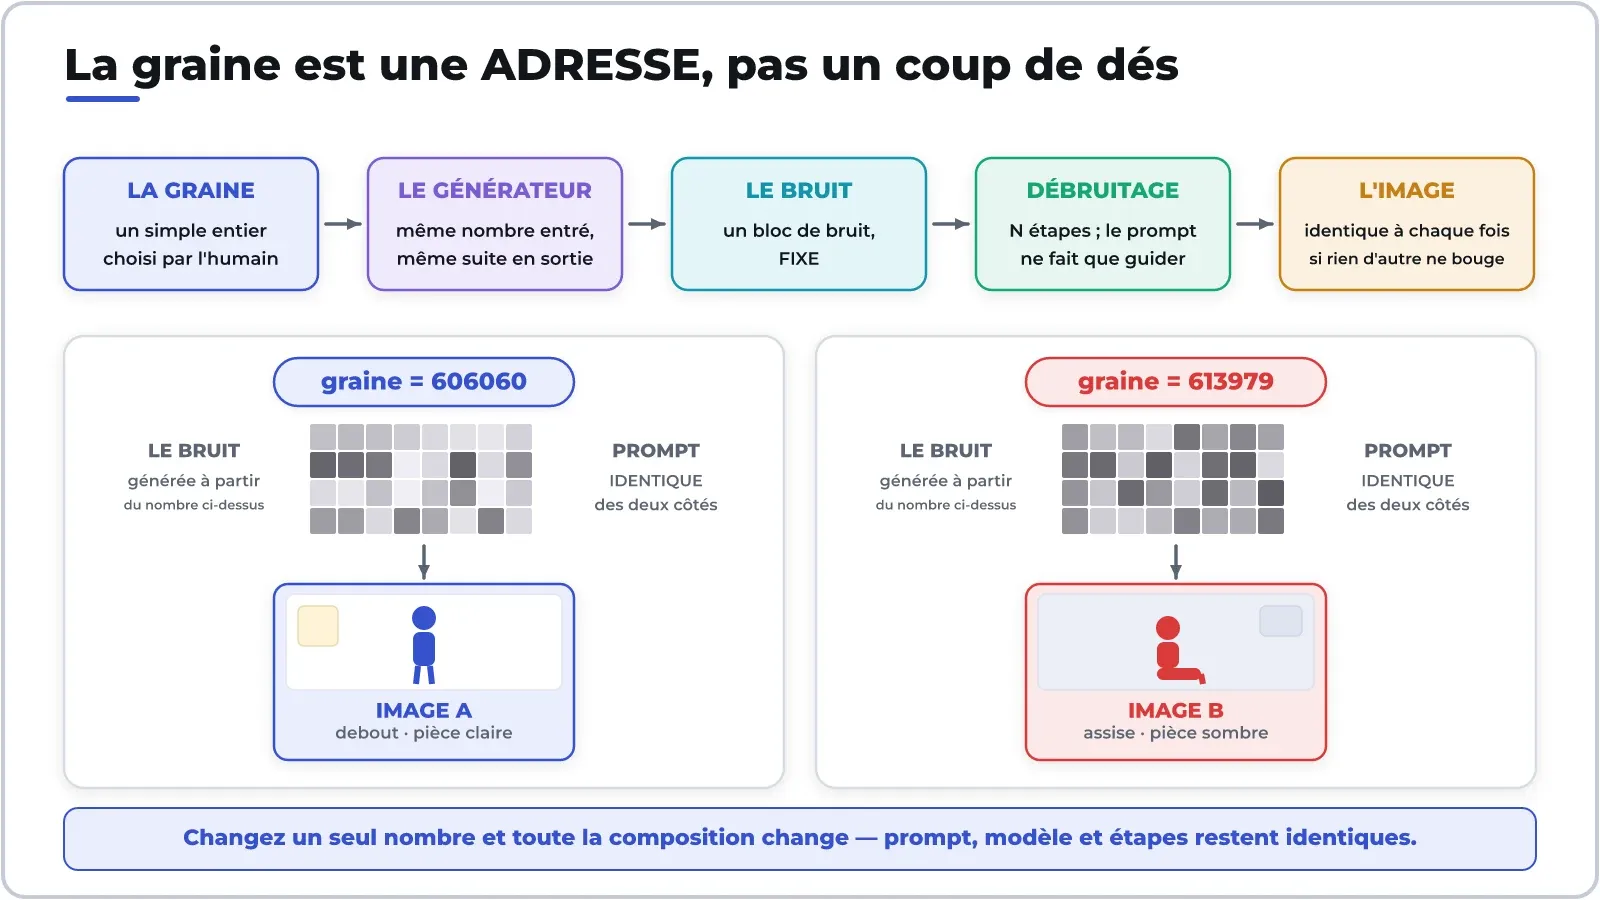
Une graine n'est pas un « nombre aléatoire ». C'est une adresse.
Les ordinateurs ne génèrent pratiquement jamais de véritables nombres aléatoires. Ce qu’ils possèdent, c’est un générateur de nombres pseudo-aléatoires : une fonction mathématique entièrement déterminée, qui prend un nombre en entrée et renvoie une longue suite d’apparence aléatoire. Si l’on entre le même nombre, on obtient exactement la même suite, aujourd’hui comme dans un an. Le nombre saisi en entrée est ce qu’on appelle la « graine ».
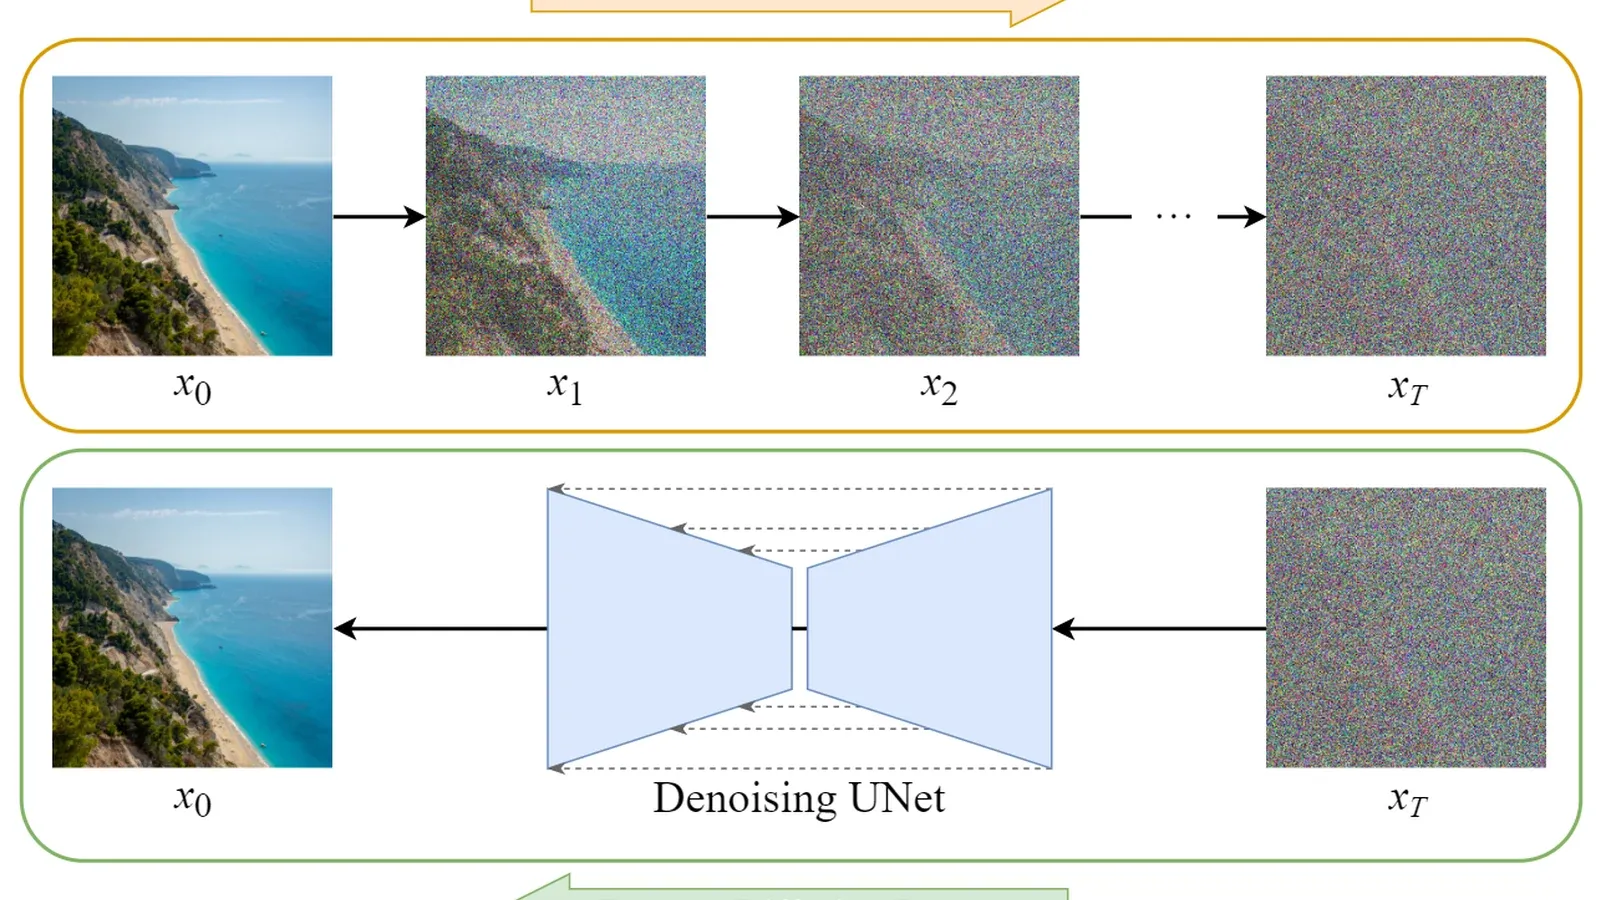
Dans un modèle de diffusion, cette séquence de nombres est injectée dans un « bruit » — un bloc de nombres de la même taille que l’image à générer (généralement dans un espace latent compressé). Tout le processus de « génération d’image » consiste ensuite à partir de ce bloc de bruit, en éliminant un peu de bruit à chaque étape, jusqu’à ce qu’il ne reste plus qu’une image. Le prompt ne dessine rien : il sert simplement de guide, orientant chaque étape vers ce qui correspond au texte.
Il faut donc comprendre les choses ainsi : les poids du modèle déterminent le relief, la consigne fait pencher ce relief, tandis que la graine vous place à un endroit précis dessus — puis vous dévalez vers la vallée la plus proche. Changer de graine ne revient pas à « ajouter un élément aléatoire », mais à changer de position.
Cette interprétation a une conséquence assez surprenante, mais très utile : la photo n’est pas créée, elle est découverte. Elle se trouvait déjà dans le bruit avant même que vous n’appuyiez sur le déclencheur — vous ne saviez simplement pas encore où vous vous trouviez.
Pourquoi les lettres ne parviennent-elles pas à l'emporter sur les chiffres ?
J’ai essayé une méthode qui semblait très logique : fournir à l’ordinateur une image existante, puis le laisser générer lui-même une prompt, créer une image, la comparer à l’image d’origine, modifier la prompt, recréer une image… et répéter ce processus plusieurs fois, dans l’espoir de se rapprocher progressivement de l’original. Le score de similitude s’est stabilisé à environ 56 sur 100, et aucune itération n’a permis de dépasser ce seuil.
La raison tient à la répartition des tâches entre les deux. Le prompt contrôle le contenu et le style : qui apparaît dans le cadre, comment sont-ils habillés, si la lumière est chaude ou froide, quel est le style de dessin. La « graine » contrôle la composition : la personne est-elle décalée vers la gauche ou vers la droite, où sont placées ses mains, quel est le rapport entre la tête et le cadre, dans quel coin se trouve la zone lumineuse. Il n’existe aucune expression en anglais pour dire « la main se trouve à cette coordonnée ». Or, c’est la composition que l’œil perçoit en premier.
D'où une règle pragmatique : ne promettez pas de recréer une image à partir d'une simple consigne. Pour conserver une image, il faut conserver à la fois la graine, le modèle, le nombre d’étapes et l’ensemble d’échantillons — s’il manque un seul élément, c’est perdu pour de bon. C’est également là que le « métier de rédacteur de prompts » atteint ses limites : au-delà d’un certain seuil, on se retrouve à lutter contre le terrain à coups de mots.
Les indices sont dissimulés à trois niveaux, et pas seulement dans les images
Premier étage — lors de l'entraînement. Les poids initiaux du réseau sont choisis au hasard, l'ordre de mélange des données est aléatoire, tout comme les couches dont on supprime des neurones. Avec la même formule, changer la graine donne un modèle différent, avec des scores différents. Les chercheurs appellent ce phénomène la « loterie des graines » : une « amélioration » observée lors d’un seul passage n’est parfois qu’un coup de chance. C’est pourquoi n = 1 ne constitue jamais une conclusion — il faut effectuer de nombreux passages puis calculer la médiane.
Deuxième étape — la génération de texte. Le modèle linguistique ne « connaît » pas le mot suivant ; il propose une distribution de probabilités, puis en tire un mot au hasard. La température et le top-p déterminent le niveau de risque de ce choix, tandis que la graine détermine la séquence de sélection spécifique. De nombreuses API de modèles linguistiques permettent désormais de passer un paramètre de graine, précisément parce que les utilisateurs ont besoin de pouvoir refaire l’opération. C’est également l’une des raisons pour lesquelles le modèle invente : pour une même question, deux tirages différents peuvent donner deux réponses tout aussi sûres l’une que l’autre.
Troisième niveau — au cœur même du matériel, et c’est celui auquel on s’attend le moins. Les nombres réels à virgule flottante ne se combinent pas : (a + b) + c n’est pas nécessairement égal à a + (b + c), car chaque addition fait l’objet d’un arrondi. Sur le GPU, une addition cumulative gigantesque est répartie entre des milliers de threads, et cette répartition dépend de la taille du lot en cours de traitement. La taille du lot dépend quant à elle… du nombre de personnes qui effectuent des requêtes simultanément.
Le résultat est très contre-intuitif : même graine, même prompt, même modèle, mais selon que le serveur est très fréquenté ou peu fréquenté, les textes générés diffèrent. C’est pourquoi régler la température sur 0 ne suffit pas à obtenir des résultats reproductibles, et c’est pourquoi, entre 2025 et 2026, l’écriture de noyaux de calcul invariants par rapport à la taille du lot est devenue un sujet technique très recherché. Quiconque a besoin d’un audit, de tests de régression ou de prouver que « la dernière fois, la machine a donné la bonne réponse à cette question » en a besoin. Découvrez également les sept idées reçues courantes sur les modèles linguistiques.
Après un bon départ : une série de résultats positifs, puis un effondrement
Supposons que vous disposiez d’une belle image de départ et que vous souhaitiez obtenir quelque chose de « similaire, mais légèrement différent » : créez des variantes, générez une séquence d’images consécutives. Une technique courante consiste à interpoler entre deux images bruitées (glissement sur une sphère, SLERP), puis à augmenter progressivement l’écart à partir de 0.
La question qui se pose est la suivante : en faisant ce réglage, l'image change-t-elle de manière régulière ou par à-coups ? J'ai effectué mes mesures sur une série de six images, avec la même paire de grains, en ne modifiant que le décalage.
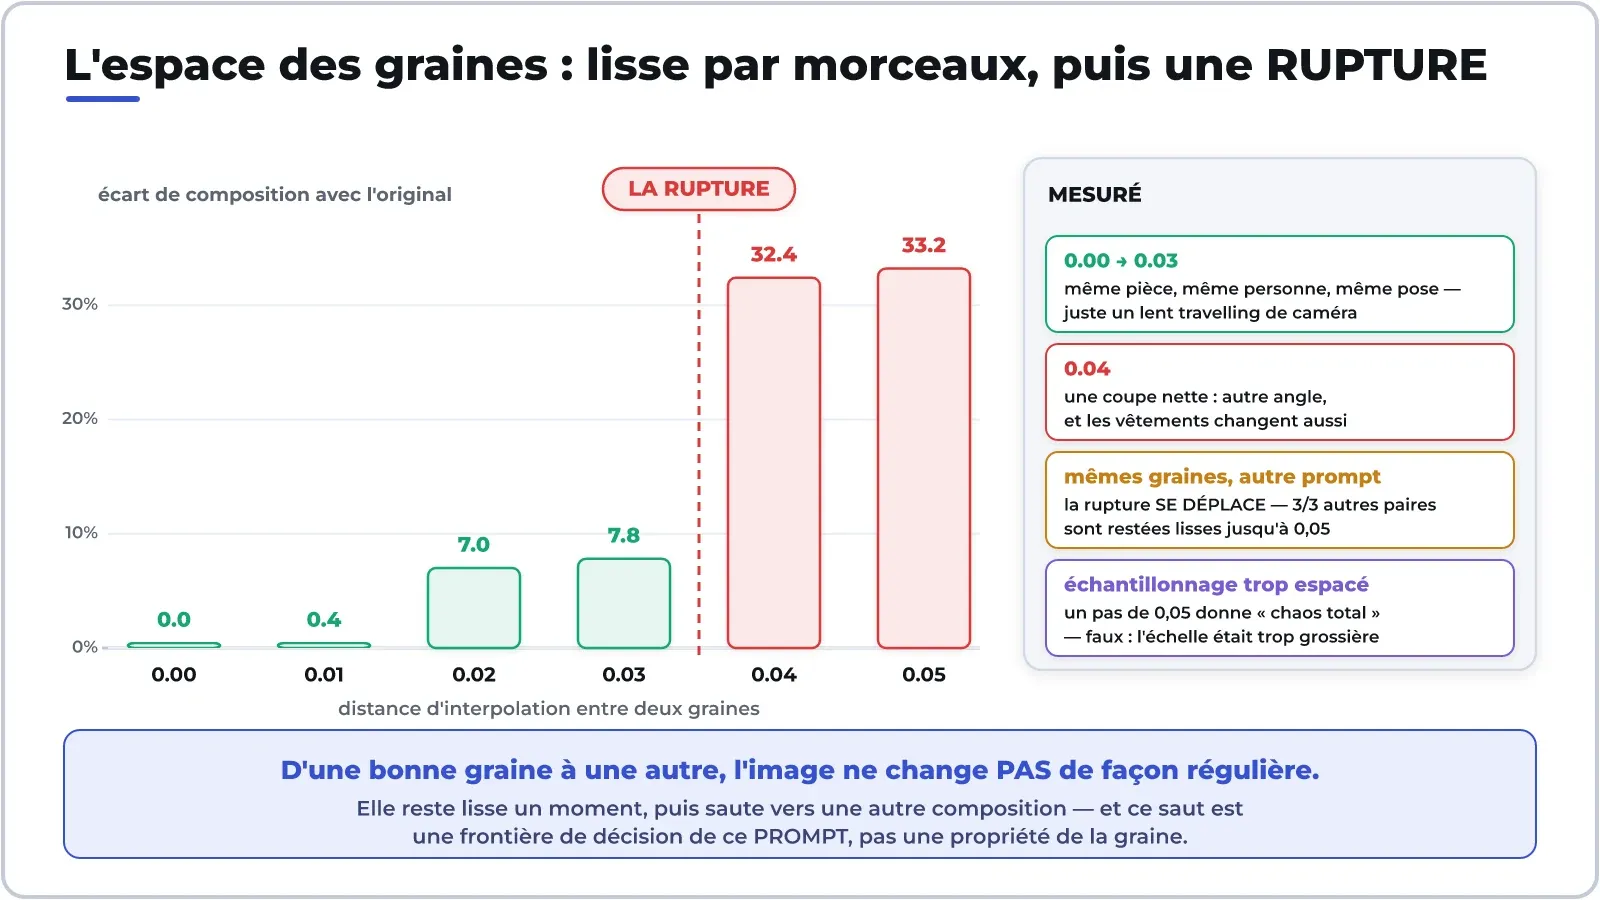
De 0,00 à 0,03, les six plans se succèdent presque comme un très lent mouvement de caméra : même pièce, mêmes personnes, mêmes postures, mêmes tenues. À 0,04, changement de plan : angle de prise de vue différent, tenue différente, position des mains différente. Le taux de décalage de la composition passe de 7,8 % à 32,4 % en un seul pas.
Mais le plus intéressant réside dans la mesure suivante. En répétant l’expérience sur trois autres paires de graines avec une autre prompt, les trois ont toutes évolué de manière fluide jusqu’à 0,05, sans qu’aucune paire ne fasse de saut. Cela signifie que cette rupture n’est ni une propriété de la graine, ni le résultat de la technique d’interpolation : il s’agit de la limite déterminante de cette prompt elle-même — le point où le modèle change d’avis sur la façon dont cette phrase doit se présenter.
Encore une leçon sur la méthode de mesure. La première fois, j’ai effectué un balayage par pas de 0,05 et j’ai failli conclure que « la courbe d’interpolation était complètement aléatoire ». Ce n’est qu’en réduisant le pas à 0,01 que j’ai pu observer une longue bande lisse. Un échantillonnage trop espacé sur une fonction non lisse donne lieu à du bruit, et ce bruit ressemble à s'y méprendre à une conclusion.
Sélection : semer, noter, puis semer à nouveau
C’est là que se révèle la réalité dérangeante de ce métier : personne ne peut optimiser la graine. C’est un nombre entier, la fonction qui le relie à la « belle image » est discontinue et n’a pas de dérivée. Il n’y a aucun gradient sur lequel glisser. Il ne reste qu’une seule solution : générer beaucoup, noter, conserver les meilleurs — une approche apparentée au « best-of-n » et à l’échantillonnage avec élimination dans les modèles linguistiques.
Ce qui transforme cette pratique de la superstition en technique, c’est le système de notation automatique. Dans mon système de génération d’images, chaque dessin terminé est évalué à l’aide de deux indicateurs simples sur le processeur — le taux de pixels surexposés et la déviation chromatique globale — ; si ces valeurs dépassent les seuils fixés, le « graines » est modifié et le dessin recommencé, jusqu’à trois fois au maximum. La machine élimine d’elle-même les images non conformes avant qu’un humain n’ait à les examiner.
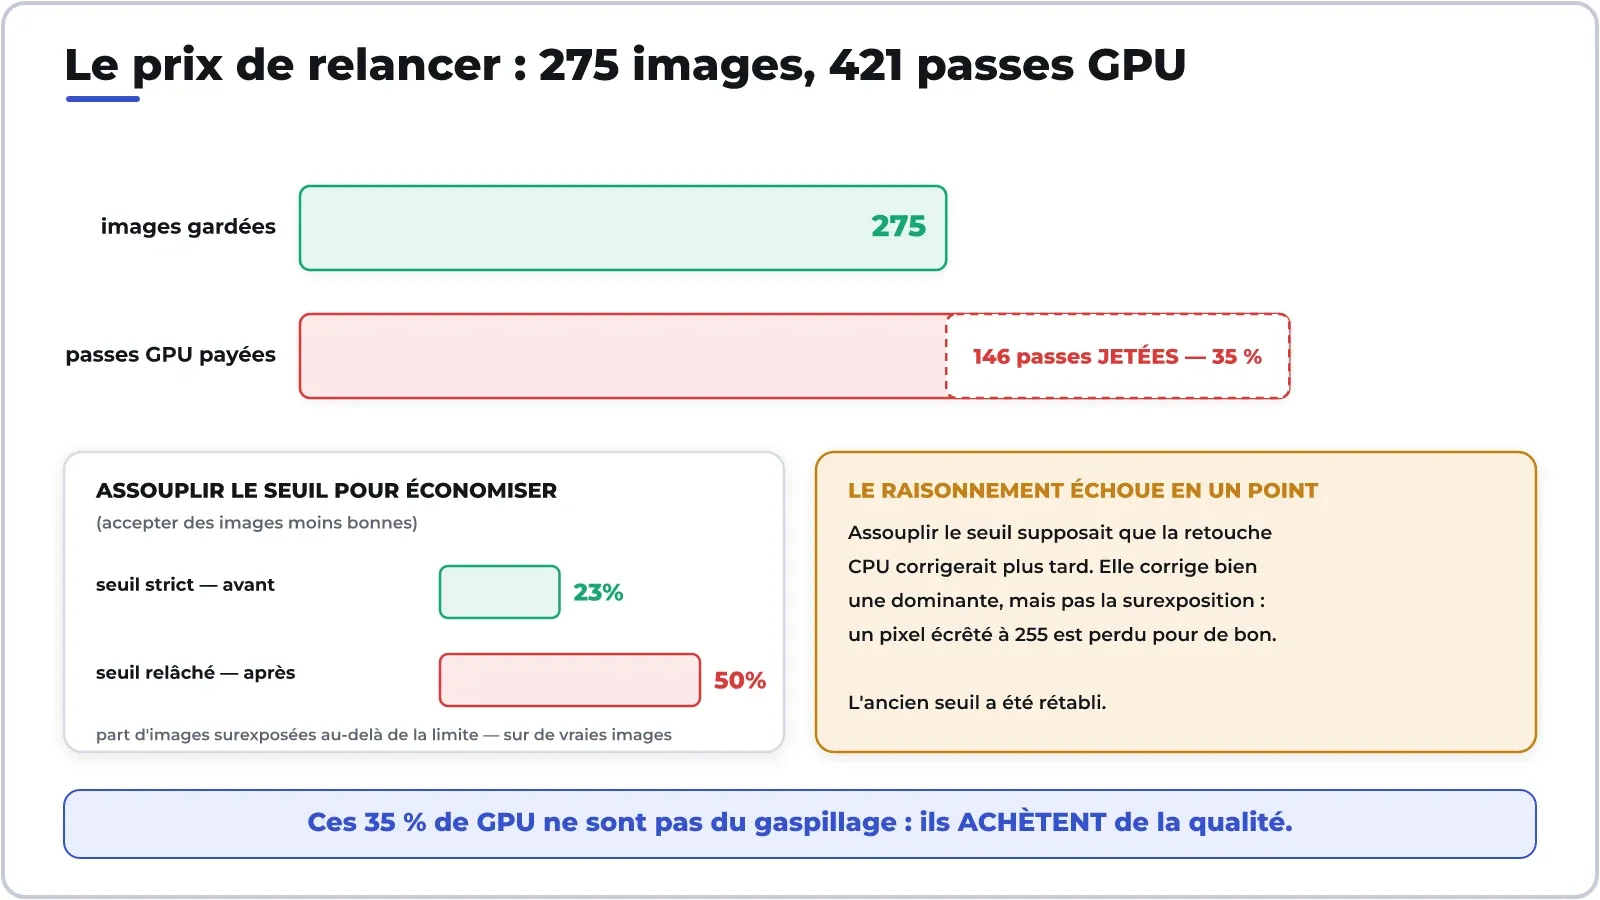
La facture est sans appel : les 275 images conservées ont nécessité 421 cycles de rendu GPU — 35 % de la puissance de calcul a fini directement à la poubelle. En voyant ce chiffre, j’ai d’abord pensé avoir trouvé un moyen de faire des économies, alors j’ai relevé le seuil pour que la machine refasse moins de rendus. Résultats des mesures suivantes : le taux d’images surexposées est passé de 23 % à 50 %, et le propriétaire de la bibliothèque d’images s’en est rendu compte immédiatement, sans qu’on ait besoin de le lui signaler.
Mon raisonnement était erroné sur un point précis : je pensais qu’il suffisait de laisser les images légèrement surexposées pour les corriger ensuite en post-production sur le processeur. Mais le post-traitement permet de corriger la dominante de couleur, pas la surexposition : les pixels bloqués à 255 ont définitivement perdu leurs informations, et aucun calcul ne permettra de les récupérer. J’ai rétabli le seuil à sa valeur initiale. Ces 35 % de GPU ne sont pas du gaspillage ; ils garantissent la qualité.
La rubrique économique : la chance s'achète à l'électricité
Chaque nouvelle itération correspond à un cycle complet du GPU. Cela signifie que le coût réel d’une image ne réside pas dans les itérations réussies, mais dans celles qui sont rejetées — et le taux de rejet dépend du seuil que vous fixez, et non du modèle. Il en découle trois conséquences financières.
Premièrement : un système de notation coûte plus cher qu'un générateur. Le générateur détermine la qualité moyenne ; le système de notation détermine le nombre d'essais nécessaires pour franchir un seuil. Si le système de notation est bon marché et précis, la facture est immédiatement réduite ; s'il est imprécis, soit on jette les résultats au rebut, soit on fait tourner le GPU à fond pour refaire les images qui avaient déjà été validées.
Deuxièmement : oublier d’enregistrer le « seed » revient à racheter ce que l’on a déjà acheté. Si l’on ne conserve pas le « seed » d’une belle image, la seule façon de la retrouver est de procéder à une recherche à l’aveugle — or, l’espace de stockage des « seeds » est si vaste qu’une recherche à l’aveugle est vouée à l’échec. Enregistrer un nombre dans les métadonnées ne coûte pratiquement rien ; ne pas le faire revient à perdre tout le temps de calcul sur le GPU déjà consacré à cette image.
Troisièmement : comparer des modèles sur la base d’un seul test revient à miser sur le hasard. L’écart entre deux modèles est parfois plus faible que celui entre deux variantes d’un même modèle. Prendre une décision d’achat d’infrastructure en se basant sur un tel chiffre revient à acheter au hasard tout en croyant agir en fonction de données concrètes.
Cette même structure de coûts se retrouve dans le modèle linguistique sous le nom de « calcul à l’exécution » : générer plusieurs solutions, les évaluer et conserver la meilleure. La facture augmente en fonction du nombre de générations, alors que le modèle ne modifie aucun paramètre — le prix par token n’est donc qu’une partie de l’histoire ; l’autre partie, c’est le nombre de fois qu’il faut générer pour obtenir un résultat utilisable.
C’est d’ailleurs pour cette raison que la meilleure approche ne consiste pas à « redessiner plus vite », mais à ne pas tout redessiner. Dans mon système, corriger localement une petite zone puis la superposer à l’ancienne image prend environ 32 à 34 secondes par image, contre environ 50 secondes pour un rafraîchissement complet — et surtout, la partie située en dehors de la zone corrigée ne subit aucune modification, ce qui évite tout risque d’altérer ce qui était déjà bon. Refaire l’image entière est la méthode la plus coûteuse parmi toutes les options de retouche.
Le vrai métier : transformer le hasard en processus
En résumé, ce qu’on appelle « l’ingénieur IA qui optimise les résultats » ne consiste pas, en fin de compte, à contrôler le hasard. Il s’agit de cinq habitudes tout à fait banales :
- Enregistrez les données directement dans le produit lui-même, sans les noter dans un registre externe. Les métadonnées intégrées dans le fichier ont une durée de vie plus longue que n’importe quel tableau.
- Effectuez plusieurs mesures, indiquez la médiane dans vos rapports, ne présentez pas le meilleur résultat — le meilleur résultat existe toujours, même avec une mauvaise méthode.
- Intégrez les graines dans les tests, afin que, lorsque les résultats changent, vous soyez sûr que cela est dû à une modification que vous venez d’apporter, et non à un caprice de la machine ce jour-là.
- Faites la distinction entre « pas de chance » et « mauvaise méthode ». Si dix graines échouent de la même manière, l’erreur réside dans la commande, le format d’image ou les paramètres — continuer à semer ne ferait que gaspiller de l’électricité.
- Conservez une bonne bibliothèque de graines accompagnée des conditions associées (quel modèle, quelle taille d’image, quel échantillonneur). Si vous changez de modèle, toute cette bibliothèque perdra sa valeur, car le contexte est différent.
L'ironie, et c'est ce qui fait tout le charme, réside ici : les professionnels compétents ne sont pas plus chanceux que les autres. Ils parviennent simplement à repérer les endroits où ils ont eu de la chance et à y revenir. Dans un environnement chaotique où rien ne permet de s'accrocher, c'est déjà là tout leur avantage.
Prévisions
- Les résultats reproductibles deviendront des produits commercialisables. Lorsque le modèle sera soumis à des audits, à des contrôles sanitaires ou juridiques, les fournisseurs proposeront un « mode déterministe » comme un niveau de service distinct — plus lent, plus coûteux, mais garantissant en contrepartie un résultat identique à l’original.
- La « graine » fera partie intégrante de la traçabilité du produit. Les images et les textes générés par l’IA porteront en eux la « graine », la version du modèle et la version du calcul de l’humanité, à la manière d’une « facture de matières premières » — à la fois pour permettre la reproduction et pour servir de preuve.
- Les systèmes de notation automatique attireront davantage d’investissements que les générateurs. Lorsque tout le monde utilise les mêmes modèles de base, ce qui fera la différence, c’est votre capacité à filtrer efficacement et le nombre de tentatives que vous êtes prêt à payer pour obtenir un résultat satisfaisant.
- La déclaration de plusieurs graines deviendra une exigence minimale. La comparaison de modèles sur un seul passage sera progressivement considérée comme des données inutilisables, tout comme le secteur du logiciel a abandonné l’habitude de mesurer les performances par un simple chronométrage.
- Les corrections locales remplaceront progressivement les réinitialisations. Corriger précisément la zone défectueuse est moins coûteux et plus sûr que de redessiner l’ensemble du cadre ; tout outil capable de transformer un « ça ne me convient pas ici » en une zone à corriger captera la majeure partie de la demande de modifications.
- Mais le bruit est toujours présent. Tant que la génération commencera par un point aléatoire, tant il y aura un métier de génération et de sélection — les outils ne font que rendre la génération moins coûteuse et la sélection plus intelligente.
Thảo luận