Mise à jour : septembre 2026.
Le 1er septembre 2026, Anthropic a annoncé la sortie de Claude Fable 5.1 et de son jumeau Claude Mythos 5.1. Le communiqué évoquait des tests de performance, mais deux détails plus intéressants se trouvaient ailleurs. Premièrement : le prix par jeton n’a pas bougé d’un centime — il reste à 10 dollars pour un million de jetons entrants, et à 50 dollars pour un million de jetons sortants — alors que l’entreprise affirme que la facture a baissé d’environ un quart. Deuxièmement : sa note technique regorge de lignes commençant par « renvoie une erreur 400 ».
Ces deux détails en disent plus long sur ce modèle que n’importe quel tableau de bord. Cet article analyse Fable 5.1 à travers sa propre API — car chaque fonctionnalité supprimée est un choix de conception, et les choix de conception sont plus révélateurs que les communiqués de presse.
Un modèle, deux niveaux de protection
Première précision à apporter : Fable 5.1 et Mythos 5.1 sont un seul et même modèle. Selon Anthropic lui-même, ils ne diffèrent que par le niveau de leurs barrières de sécurité. Fable 5.1 est disponible au grand public ; Mythos 5.1 n’est accessible aux utilisateurs que via un programme d’accès privilégié, avec des barrières de sécurité spécialement conçues pour la cybersécurité et les sciences de la vie.
Il s’agit là d’une distinction notable, qui n’est pas d’ordre technique : l’entreprise sépare les CAPACITÉS des DROITS. À poids égal, ce que chacun est autorisé à faire dépend du fait que vous ayez été vérifié ou non. Auparavant, cette frontière se situait à l’intérieur du modèle : un modèle puissant s’accompagnait de barrières strictes, et les utilisateurs légitimes subissaient les mêmes blocages que les utilisateurs malveillants. Désormais, cette frontière est repoussée vers l’extérieur, pour devenir une question d’identité et de contrat.
Le reste du tableau des spécifications : code du modèle claude-fable-5-1, fenêtre contextuelle d’un million de tokens (la valeur maximale correspondant à la valeur par défaut), sortie maximale de 128 000 tokens, disponible sur toutes les principales plateformes, notamment Amazon Web Services, Google Cloud et Microsoft Azure.
Lire correctement les numéros
Anthropic a publié une série de scores. Mais en y regardant de plus près, un seul résultat a été publié avec un point de référence pour le même modèle : Terminal-Bench-Science 0.1, où Fable 5.1 atteint 52,6 % contre 24,7 % pour Fable 5 — soit 2,1 fois plus.
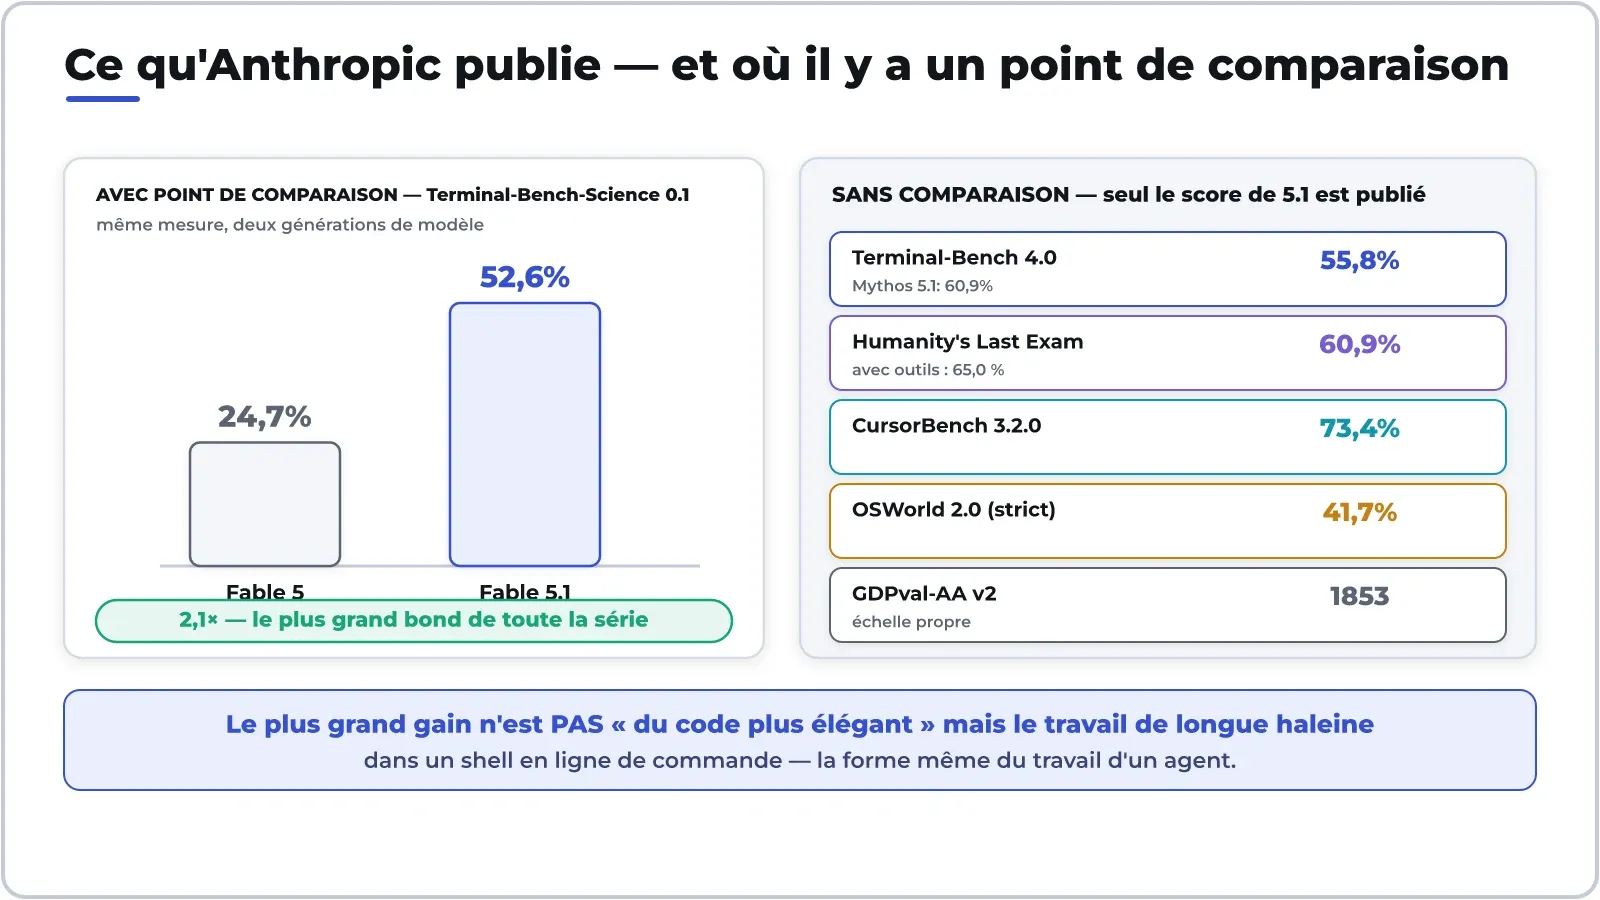
Quant aux autres résultats : Terminal-Bench 4.0 a atteint 55,8 % (la version Mythos 5.1 a atteint 60,9 %), Humanity’s Last Exam a atteint 60,9 % sans outil et 65,0 % avec, CursorBench 3.2.0 atteint 73,4 %, OSWorld 2.0 (version stricte) 41,7 %, GDPval-AA v2 atteint 1 853 — ne présentent que les chiffres de la nouvelle version. Ces chiffres indiquent la puissance du modèle, mais ne précisent pas dans quelle mesure il a progressé. Il s’agit de deux questions distinctes, et les confondre est le moyen le plus simple de mal interpréter un communiqué de presse.
Ce que ce tableau révèle réellement, c’est où se situe la plus grande progression : il s’agit d’une mesure du travail de fond dans un environnement en ligne de commande, et non d’une mesure de la qualité du code. C’est exactement le type de travail d’un agent : recevoir un objectif vague, se débrouiller seul dans un shell, se corriger en cas d’erreur, et exécuter des dizaines d’itérations sans que personne ne le guide.
Sur le plan scientifique, l'entreprise a présenté deux exemples concrets à la place des notes : un taux de réussite de près de 50 % dans la conception de protéines, et une carte altimétrique de la surface de Vénus dont le niveau de détail a été amélioré de 2 à 3 km. Il s’agit là de résultats mesurés en termes de produits et non selon une échelle de notation — et c’est aussi le type de résultats le plus difficile à vérifier de manière indépendante.
Une remarque d'ordre méthodologique, dans l'esprit de cet article consacré aux courses de modèles réduits : tous les chiffres ci-dessus ont été communiqués par le fabricant lui-même. Ils méritent d'être pris en compte, mais ne remplacent en aucun cas les mesures effectuées lors de vos propres essais.
La pensée n'est plus un simple interrupteur
C’est là que l’API commence à parler sans détours. Sur Fable 5.1, la réflexion est toujours activée et ne peut pas être désactivée. Si vous envoyez thinking: {type: "disabled"} , on obtient une erreur 400. Si l’on envoie une requête à l’ancienne budget_tokens — c’est-à-dire en définissant au préalable un budget de jetons pour que le modèle puisse réfléchir —, on obtient également une erreur 400.
Il s'agit plutôt d'un paramètre d'une nature tout à fait différente : effort cinq niveaux, allant de « low » à « max ». La différence ne réside pas dans la syntaxe, mais dans la question de savoir à qui revient la tâche de deviner. Le budget en jetons vous oblige à anticiper la difficulté du problème, puis à allouer exactement la quantité nécessaire : si vous sous-estimez la difficulté, le modèle s’interrompt en cours de route ; si vous la surestimez, vous payez pour la partie inutilisée. En revanche, effort il suffit de dire « jusqu’où aller » et de laisser le modèle s’allouer les ressources étape par étape. Celui qui sait à quel point le problème est difficile, c’est celui qui le résout, pas celui qui passe la commande.
La chaîne de raisonnement brute n’est jamais renvoyée, quel que soit le paramétrage. Vous pouvez uniquement choisir le mode d’affichage : par défaut, elle est laissée vide ; l’option « summarized » renvoie un résumé lisible ; et l’option « updates » — nouvelle dans cette version — renvoie de brèves notes d’avancement rédigées par le modèle entre chaque appel de l’outil.
Cette troisième option découle d'un problème très concret : un appel sur ce problème peut durer plusieurs minutes. Du point de vue de l’interface utilisateur, plusieurs minutes de silence sont impossibles à distinguer d’un blocage du système. Par conséquent, si vous envisagez d’utiliser ce modèle pour une application où des utilisateurs réels doivent patienter, vous devrez repenser entièrement le flux de données et les temps d’attente — il ne s’agit plus d’un modèle offrant une réponse en deux secondes.
Il ne faut pas arracher les pages de ce cahier
Et voici le changement le plus discret, mais aussi le plus important pour quiconque développe un agent.
Dans Fable 5.1, les blocs de pensée sont étroitement liés au modèle qui les a générés et à leur emplacement exact dans l'historique de la conversation. Si l’on modifie un tour déjà passé, l’ensemble des blocs de pensée qui le composent perdent leur validité. Pour les comptes ouverts à partir du 31 août 2026, cela ne constitue plus un simple avertissement, mais une erreur 400 pure et simple. Anthropic appelle ce mécanisme « preserved thinking » — la pensée préservée.
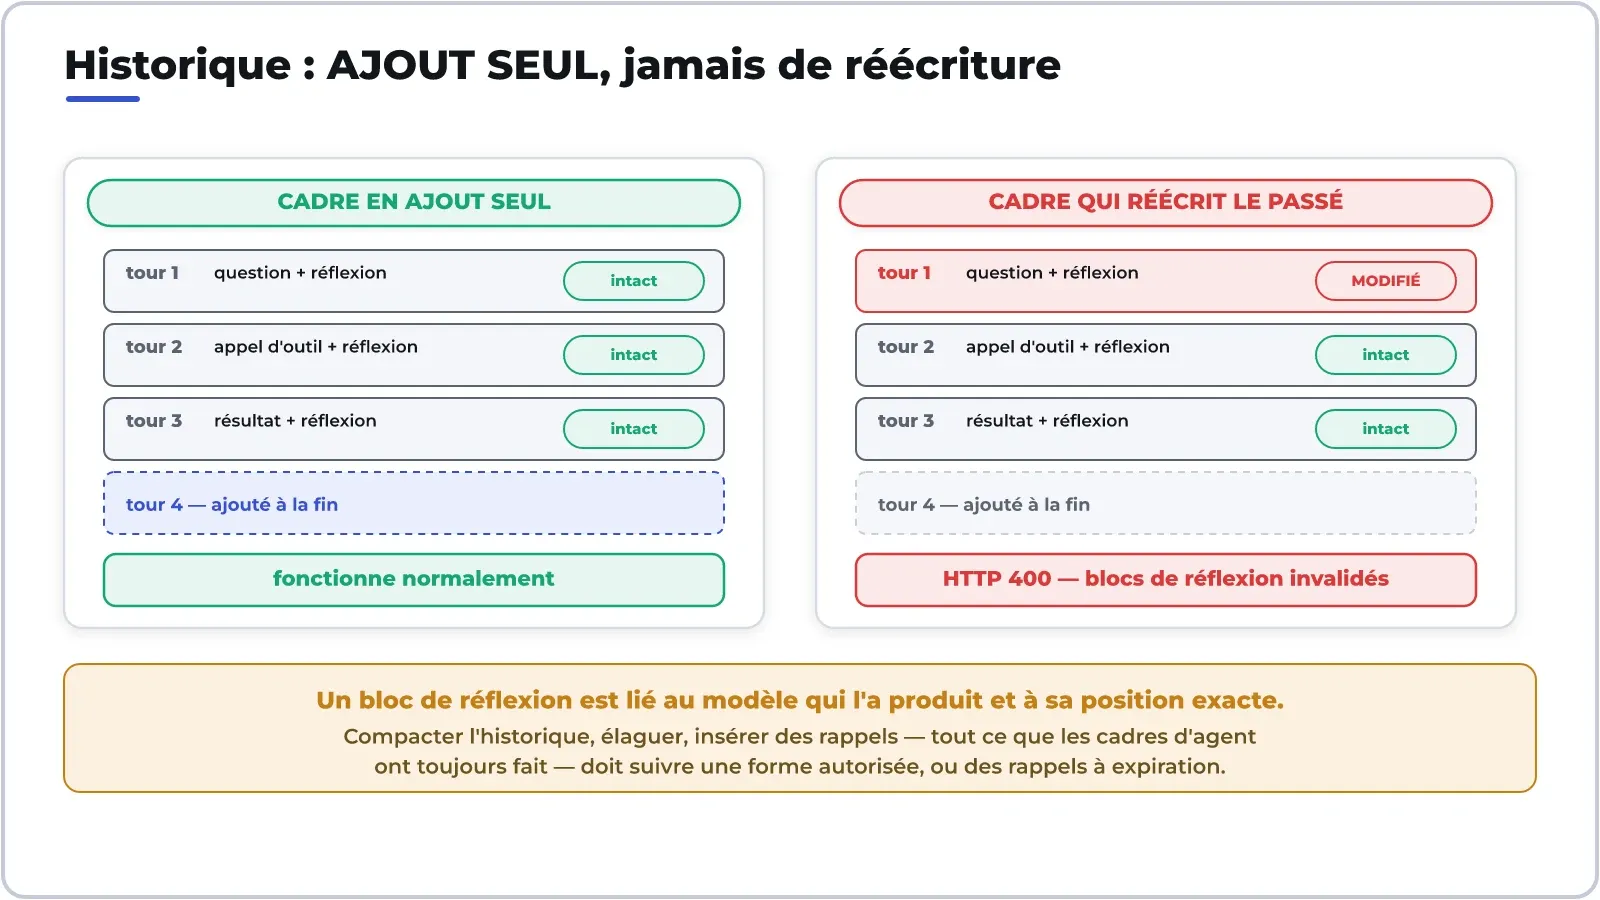
Pour comprendre pourquoi c’est lourd, il faut se rappeler ce que les frameworks d’agents ont toujours fait avec l’historique des conversations : ils le réécrivent à leur guise. Compresser l’ancien contenu pour économiser du contexte. Tronquer les résultats trop longs générés par les outils. Insérer une ligne de rappel au milieu. Reformuler les anciennes questions pour les raccourcir, puis renvoyer le tout. Toutes ces opérations reposent sur une hypothèse que personne n’a encore formulée : le passé est un brouillon, que l’on peut modifier à tout moment.
Fable 5.1 rejette cette hypothèse. Le passé est désormais une preuve, pas un brouillon. Votre structure doit devenir une structure « à ajout seul » : tout ce qui est nouveau va à la fin, sans exception. Si vous souhaitez rappeler quelque chose au modèle à chaque tour, utilisez le type de message système à expiration automatique (clear_at: "next_user_message") — il s’affiche pendant un tour, puis disparaît de lui-même, ce qui vous évite d’avoir à supprimer l’ancien. Quant à la compression de l’historique, elle doit respecter la forme autorisée, sans coupures ni collages arbitraires.
D’un point de vue plus large, cela s’inscrit dans la même lignée que ce que j’ai écrit dans mon article sur les graines : les résultats reproductibles deviennent peu à peu un argument de vente. Un modèle capable de prouver que « c’est bien cette chaîne de raisonnement qui a conduit à cette réponse, sans qu’aucune modification n’ait été apportée en cours de route » est un modèle utilisable pour l’audit. Le prix à payer, c’est la liberté de celui qui élabore le cadre.
Deux autres points : l'appel forcé de l'outil et le refus
L'appel forcé d'un outil a été supprimé. L'ancienne méthode — qui obligeait le modèle à appeler un outil spécifique — renvoie désormais un code d'erreur 400. La raison est assez évidente quand on considère son véritable objectif : la plupart des utilisateurs recouraient à l'appel forcé d'un outil uniquement pour récupérer un bloc JSON conforme au format requis. Il existe désormais une méthode plus directe pour cela : activer strict dans la définition de l’outil pour que les paramètres soient toujours valides, ou d’utiliser une sortie structurée. Ce raccourci a été supprimé, car il existe désormais une méthode standard.
Le refus devient un état à gérer. Lorsque le classificateur de sécurité bloque une requête, l’API ne renvoie pas d’erreur — elle renvoie un code HTTP 200 accompagné stop_reason: "refusal" d’un code de classification. Cela signifie que tout code qui lit directement le contenu sans effectuer de vérification stop_reason au préalable se retrouvera face à une chaîne vide et ne comprendra pas pourquoi. En contrepartie, il existe un nouveau mécanisme : en déclarant un « fallback », en cas de refus, l’API réexécute automatiquement la requête en question sur un autre modèle au sein du même appel, et le refus survenu avant même que le contenu ne soit généré n’est pas facturé.
En associant cette information à un chiffre mentionné dans le communiqué, on obtient une vue d’ensemble : Anthropic affirme que les utilisateurs de Claude Code seront confrontés à environ 60 % de cas d’intervention des barrières de sécurité informatique en moins par session par rapport à Fable 5, et que ce modèle est désormais autorisé à être utilisé pour rechercher des failles logicielles. Ce sont les deux facettes d’une même réalité : assouplir les règles là où il le faut, tout en prévoyant une issue de secours pour les cas où un blocage erroné se produirait malgré tout. Les blocages erronés constituent le prix que les utilisateurs légitimes doivent payer pour bénéficier de ces barrières de sécurité ; réduire ce prix est une fonctionnalité concrète, et non une simple opération de communication.
Le coin économique : c'est dans le cache que réside l'économie
Revenons à la paradoxale situation évoquée au début de cet article. Le prix d'entrée et de sortie des jetons reste inchangé. Ce qui change, c'est le prix lu dans le cache : il est 75 % moins cher, soit 0,25 dollar pour un million de jetons.
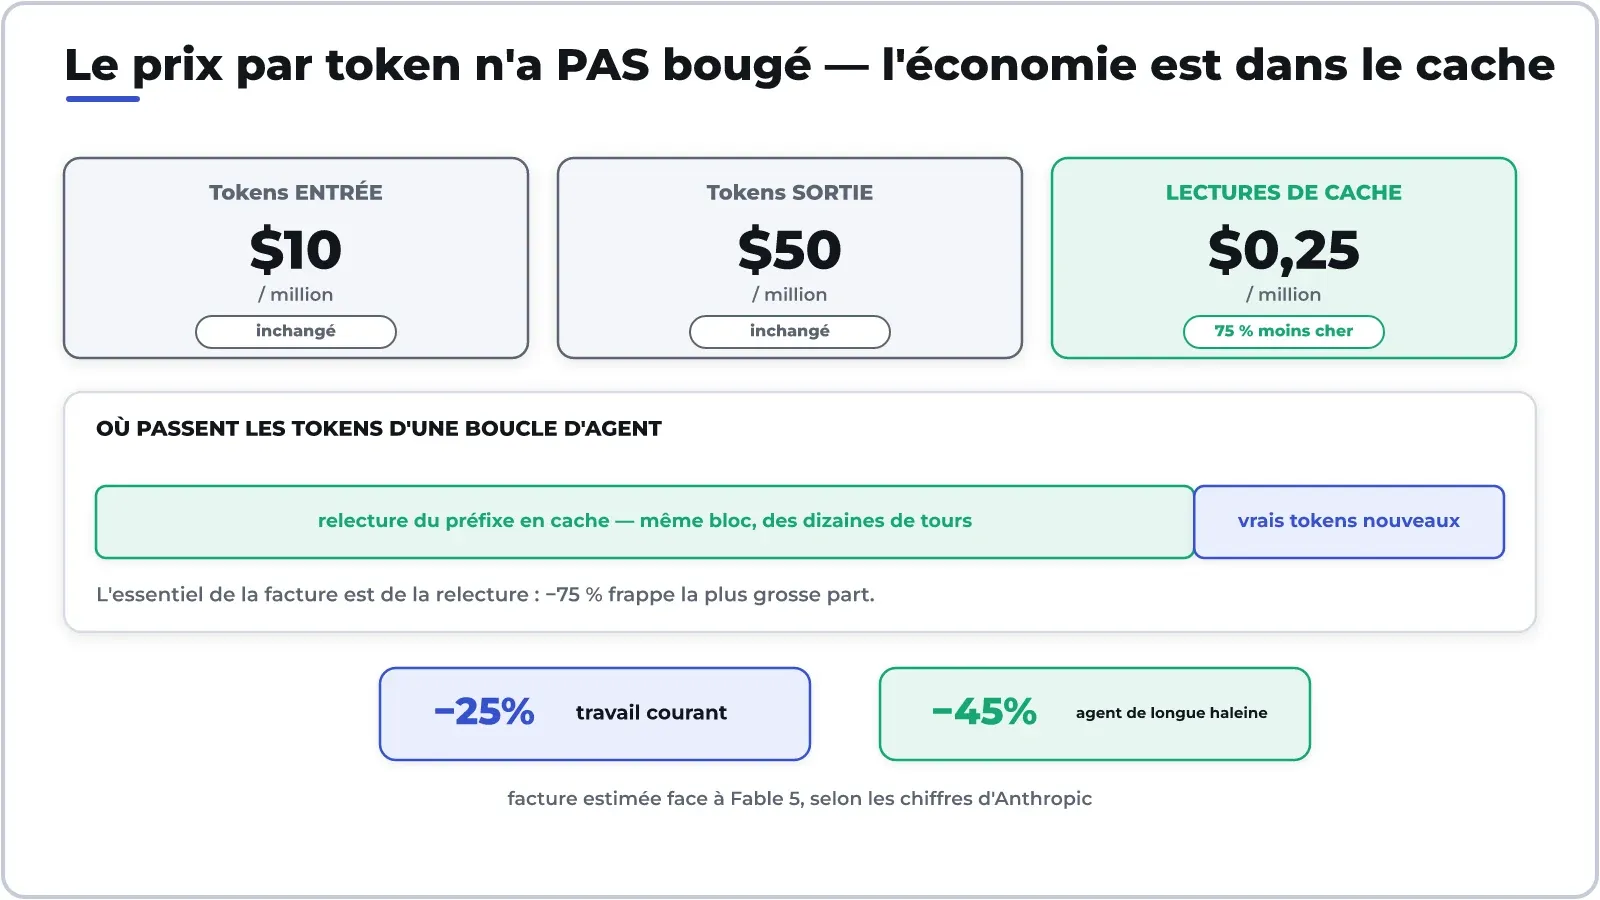
Pourquoi un changement aussi mineur permet-il de réduire la facture d’un quart ? Parce que, dans une boucle d’agent, la plupart des jetons que vous payez ne sont pas de nouveaux jetons. Si l’agent s’exécute vingt fois, il renvoie vingt fois pratiquement le même préfixe : la description du système, la liste des outils, l’historique depuis le début. La partie nouvellement générée à chaque itération n'est qu'un fragment. Réduire le coût de la relecture revient à réduire précisément la partie la plus importante de la facture — et c'est également la raison pour laquelle l'entreprise estime que l'on économise généralement environ 25 %, tandis qu'un agent à long terme permet d'économiser jusqu'à environ 45 %.
Il en découle trois conséquences pratiques.
Premièrement : conserver un préfixe fixe est aujourd’hui le moyen le plus économique dont vous disposez. La mémoire cache s’aligne sur le préfixe — un octet modifié au début corrompt tout ce qui suit. Un horodatage dans la description du système, une liste d’outils non fixe, suffit pour que chaque itération doive payer le prix fort. Auparavant, cette erreur coûtait cher ; aujourd’hui, elle coûte bien plus cher, car la partie que vous perdez a vu son coût divisé par quatre.
Deux : « effort » est le deuxième levier de contrôle des coûts, et c'est vrai. Selon le même principe, réduire le niveau d'effort revient à réduire le nombre de tokens de réflexion, le nombre d'appels aux outils et le nombre de messages. Pour la classification ou les questions-réponses courtes, un niveau bas ne coûte généralement rien ; pour la programmation à long terme, en revanche, il vaut mieux augmenter ce niveau.
Troisièmement : mesurez le coût par TÂCHE RÉALISÉE, et non par appel. Fable 5.1 coûte deux fois plus cher qu’Opus 5 — 10/50 dollars contre 5/25 dollars — et cinq fois plus cher que Sonnet 5. Un appel moins cher qui nécessite trois itérations pour mener à bien la tâche n’est en réalité pas moins cher. C’est la seule comparaison qui ait du sens, et c’est aussi celle à laquelle seules vos propres données peuvent répondre. Consultez l’article sur l’algorithme de détermination du prix par jeton pour comprendre pourquoi les chiffres indiqués dans la grille tarifaire ne correspondent pas à ce que vous payez réellement.
Enfin, il y a deux coûts qui ne se mesurent pas en argent, et ce sont peut-être eux qui pourraient vous freiner : Fable 5.1 impose une durée de conservation des données de 30 jours — toute organisation fonctionnant sans conservation des données se verra refuser l’accès, sauf autorisation spéciale d’Anthropic — et il n’y a pas de « Priority Tier », ce qui signifie qu’il n’est pas possible d’acheter un accès prioritaire lorsque le système est saturé.
Prévisions
- « Juste ajouter » deviendra la valeur par défaut de tous les frameworks d’agents. Lorsqu’un grand fournisseur fera de la réécriture de l’historique une erreur matérielle, les bibliothèques suivront le mouvement — et l’habitude de copier-coller arbitrairement le contexte restera dans les mémoires comme une phase transitoire.
- Sur le front des prix, l’accent passe des jetons au cache. Le prix par jeton est resté stable pendant deux cycles de modèles consécutifs, tandis que le prix de la relecture a baissé de 75 %. La concurrence sur les prix se jouera sur la « relecture de ce qui est déjà connu », car c’est là que réside le véritable volume.
- Le niveau d’effort sera visible pour l’utilisateur final. Aujourd’hui,
effort, ce sont les paramètres du développeur ; bientôt, des produits permettront aux utilisateurs de choisir directement sur l’interface entre « réponse rapide » et « réflexion approfondie, plus coûteuse ». - La distinction entre Fable et Mythos sera reproduite. Séparer les capacités des droits — même modèle, barrières différentes selon les utilisateurs vérifiés — résout le dilemme auquel tous les laboratoires sont confrontés, il est donc peu probable qu’une seule entreprise s’en charge.
- L’origine du contenu passera de la fonctionnalité aux clauses contractuelles. Une fois que le contenu généré par le modèle aura été certifié, les acheteurs dans les secteurs réglementés commenceront à exiger cette certification, et ne se contenteront plus de l’utiliser si elle est disponible.
- Mais les tableaux de bord auto-déclarés resteront insuffisants. Tant qu’une seule mesure de l’ensemble ne disposera pas d’un repère de comparaison de même génération, les acheteurs sérieux devront continuer à établir eux-mêmes leur propre système de mesure à partir de leur propre travail — et cela reste la tâche la plus laborieuse de toute cette démarche.
Thảo luận