Mise à jour : septembre 2026.
Ces deux phrases sont des traductions authentiques, tirées de mes archives :
- OnlyOffice → « Only Mohammad »
- « BỘ SINH SỐ » → « DEPARTMENT OF BIOMATICS »
Les deux sont des traductions automatiques. Mais elles proviennent de deux services différents et, surtout, ont deux causes tout à fait distinctes. L'une peut être corrigée en changeant de service. L'autre, en revanche, reste identique, quel que soit le nombre de fois où l'on change de service.
Cet article présente les conclusions que j'ai tirées après avoir traduit plus de 230 articles techniques en trois langues : ce qui ne fonctionne pas, pourquoi cela ne fonctionne pas, et quelles solutions sont réellement efficaces.
Deux types de problèmes, et attention à ne pas utiliser le mauvais remède
Premier cas : le logiciel traduit même ce qu’il ne devrait pas traduire. Le traducteur hébergé sur mon propre serveur que j’ai testé en premier fonctionnait très bien, mais il considérait les noms propres comme des mots courants. « OnlyOffice » est devenu « Only Mohammad ». Photoshop est devenu « Bristol ». C’est une erreur fatale dans un document technique, car ce sont précisément les noms propres que le lecteur va rechercher : si le nom du logiciel est mal traduit, toute la phrase perd tout son sens.
Deuxième cas : le système ne dispose pas de suffisamment de mots pour deviner le sens. Le meilleur service commercial que j’utilise gère parfaitement les noms propres et traduit le texte courant avec fluidité — mais lorsqu’il tombe sur une étiquette de deux ou trois mots, il invente des choses comme « DEPARTMENT OF BIOMATICS ». Voici quelques autres exemples tirés de ma base de données :
- « SỐ HẠT GIỐNG » → « NUMBER OF SEEDS » (nombre de graines — alors qu’il s’agit de la valeur des graines)
- « nhận mẫu » → « select font » (le système interprète « police » comme une police de caractères)
- « tiền huấn luyện » → frais de formation (le système interprète « argent » comme de l’argent, et non comme le préfixe « pré »)
- « token nạp vào » → « 入金 » en japonais, c'est-à-dire « verser de l'argent sur un compte »
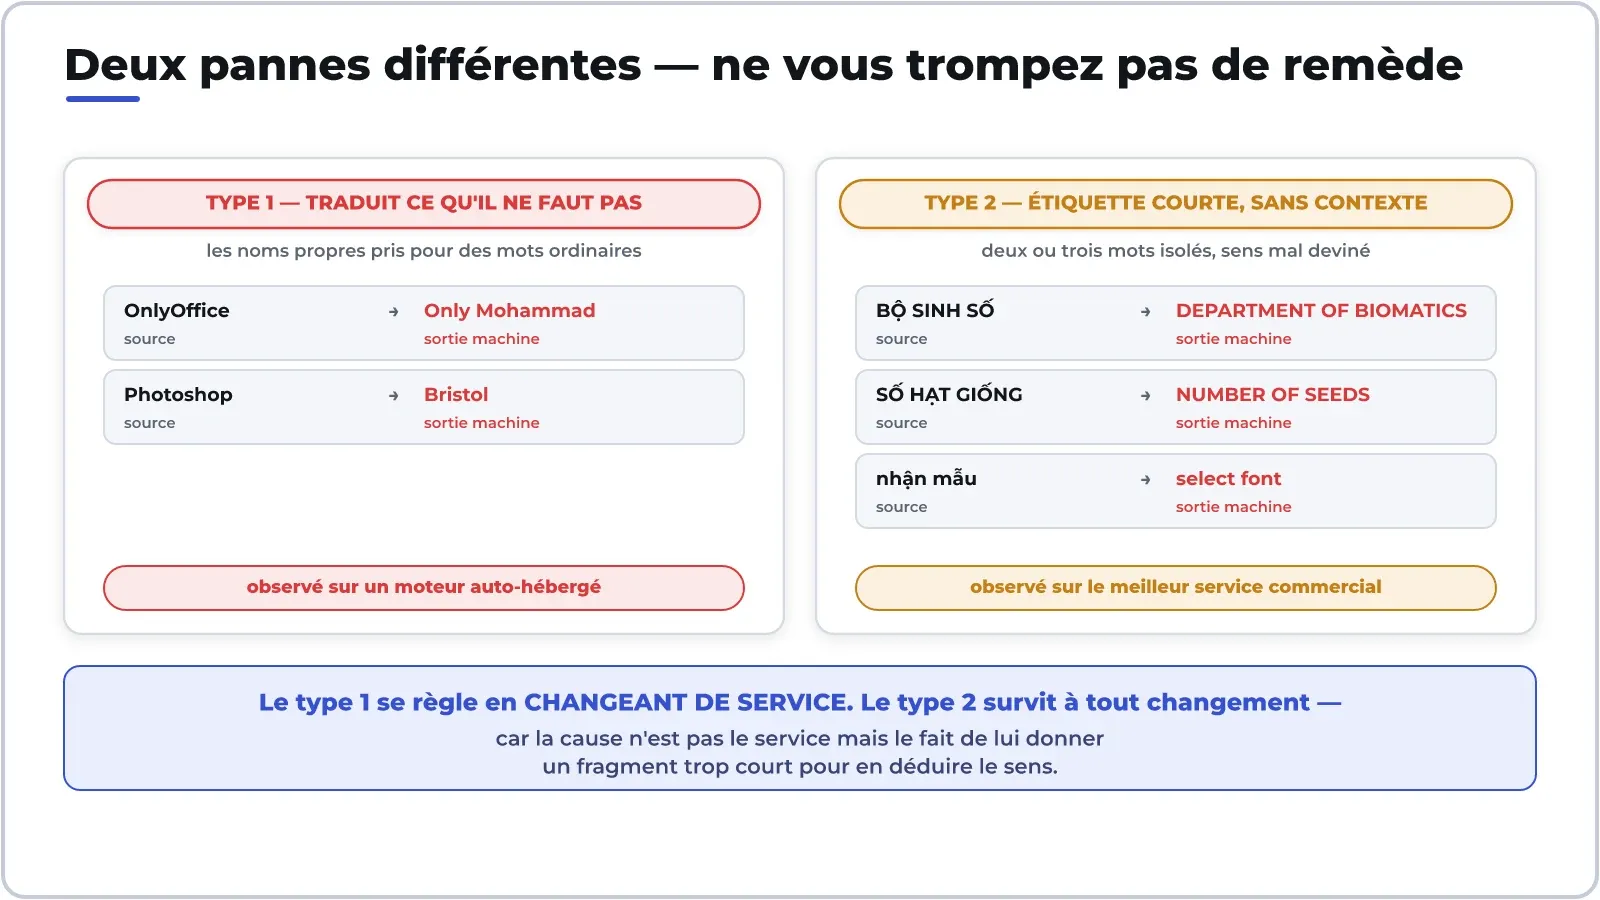
En regardant cette liste, on constate une règle : le programme ne fait pas d’erreurs de grammaire, mais d’erreurs de SENS — et il se trompe justement là où le vietnamien comporte des homophones que seul le contexte permet de distinguer. Or, avec des étiquettes de deux ou trois caractères, il n’y a pas de contexte.
Pourquoi la « protection » des noms propres ne fonctionne-t-elle pas ?
Dans le premier cas, le réflexe naturel est de protéger le nom propre avant de le saisir dans l'ordinateur. J'ai essayé deux méthodes, et les deux ont échoué — je note cela ici pour éviter à quelqu'un d'autre de perdre son temps comme moi.
Méthode 1 — remplacer les noms propres par des codes de remplacement (du type XKEEP0X), puis le remplacer à nouveau une fois la traduction terminée. Résultat : le système a supprimé la moitié de la phrase. Le caractère de remplacement n’ayant aucun sens pour lui, il a traité le reste comme une phrase incomplète et l’a tronquée de son propre chef.
Méthode n° 2 — placer le nom propre entre les balises `<code>` afin que le système le considère comme du code de programmation et l'ignore. Résultat : le nom propre est conservé tel quel, mais la syntaxe qui l'entoure est fragmentée — la phrase semble alors coupée en morceaux.
La leçon commune à ces deux cas : intervenir sur la chaîne d’entrée revient à intervenir sur ce même élément que la machine utilise pour déduire la grammaire. En supprimant un fragment de phrase, on supprime également l’indice dont elle a besoin pour reconstituer la phrase à l’autre bout.
La solution est en réalité si simple qu’elle en devient presque ennuyeuse : changer de service. Les services commerciaux indiquent clairement leur nom dès le départ, sans rien dissimuler. En d’autres termes, choisissez un outil en fonction des faiblesses que vous ne pouvez pas supporter, et non en fonction des points forts qui semblent séduisants.
La phrase s'écoule, la pastille se brise
Après être passé au service commercial, j'ai effectué des mesures sur l'ensemble des caractères figurant dans les schémas illustrés, et une régularité est apparue très clairement :
- Les phrases complètes : bien traduites. Les longues phrases du schéma et l'ensemble du texte en prose sont traduits de manière lisible, en respectant la terminologie, sans nécessiter de correction.
- Les étiquettes de deux ou trois mots : souvent incorrectes. Surtout les étiquettes en MAJUSCULES, car les majuscules font également perdre tout indice sur la nature grammaticale du mot.
Cela semble évident quand on y pense, mais cela va à l'encontre d'une pratique courante : on a tendance à extraire les étiquettes dans un fichier séparé, puis à transmettre l'intégralité de ce fichier au logiciel de traduction, car c'est plus simple. Or, c'est justement cette simplicité qui nuit à la qualité : vous privez ainsi chaque fragment de texte de son contexte.
Si l'on est obligé de traduire des étiquettes séparées, il y a deux solutions : ajouter une phrase de contexte, ou ne plus les faire traduire par le logiciel.
Dictionnaire de remplacement : la solution la moins chère
La deuxième méthode est celle que j'utilise actuellement, et elle est étonnamment bon marché. Le principe tient en une seule phrase : avant de faire appel à un traducteur automatique, consultez un dictionnaire rédigé par un humain ; si le mot s'y trouve, utilisez-le directement ; s'il n'y figure pas, alors faites appel au traducteur automatique.
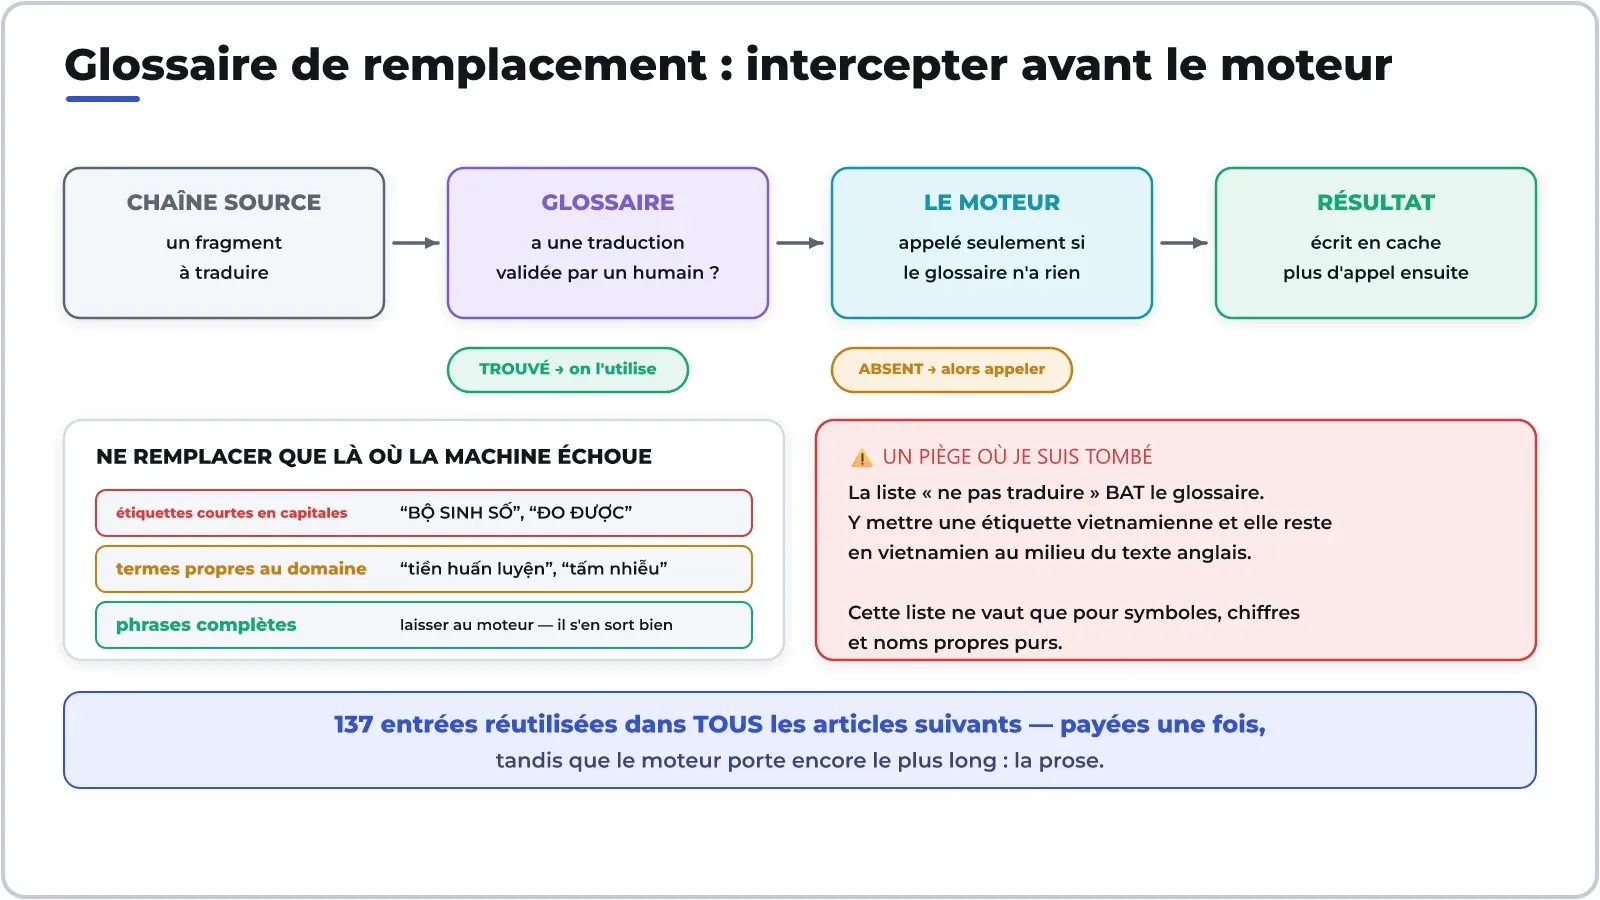
L'essentiel, c'est que vous n'avez pas besoin de traduire manuellement l'intégralité du document : il suffit de corriger les passages où le logiciel fait des erreurs. Actuellement, mon dictionnaire contient 137 expressions, presque exclusivement des étiquettes courtes et des termes propres à mon domaine. La partie la plus longue, c’est-à-dire le texte en prose, reste à la charge de la machine. Et ces 137 expressions peuvent être réutilisées pour tous les articles suivants : un effort fourni une seule fois, dont la valeur ne cesse de s’accumuler.
La plupart des services commerciaux proposent désormais cette fonctionnalité sous le nom de « glossaire » — mais même si vous le rédigez vous-même, il ne s'agit que d'un tableau de référence et d'une consigne du type « à utiliser si nécessaire ».
Un piège s’est refermé, je le note pour que personne d’autre ne tombe dedans : si votre outil dispose d’une liste « à ne pas traduire » (pour conserver les codes, symboles et noms propres), vérifiez que cette liste a la priorité sur le dictionnaire. C’est le cas pour le mien. J’ai ajouté une étiquette en vietnamien à la liste « Ne pas traduire » par mesure de sécurité — résultat : cette étiquette est restée en vietnamien au milieu du texte anglais. La liste « Ne pas traduire » ne devrait contenir que des symboles, des chiffres et des noms propres.
Ce sont les caractères de l'IMAGE qui sont le plus coûteux
Si votre document contient des schémas, des graphiques ou des captures d'écran annotées, cette partie demande plus de travail que l'ensemble du texte en prose. Non pas parce que la traduction est difficile, mais parce que la traduction prend plus de place, alors que le cadre reste le même.
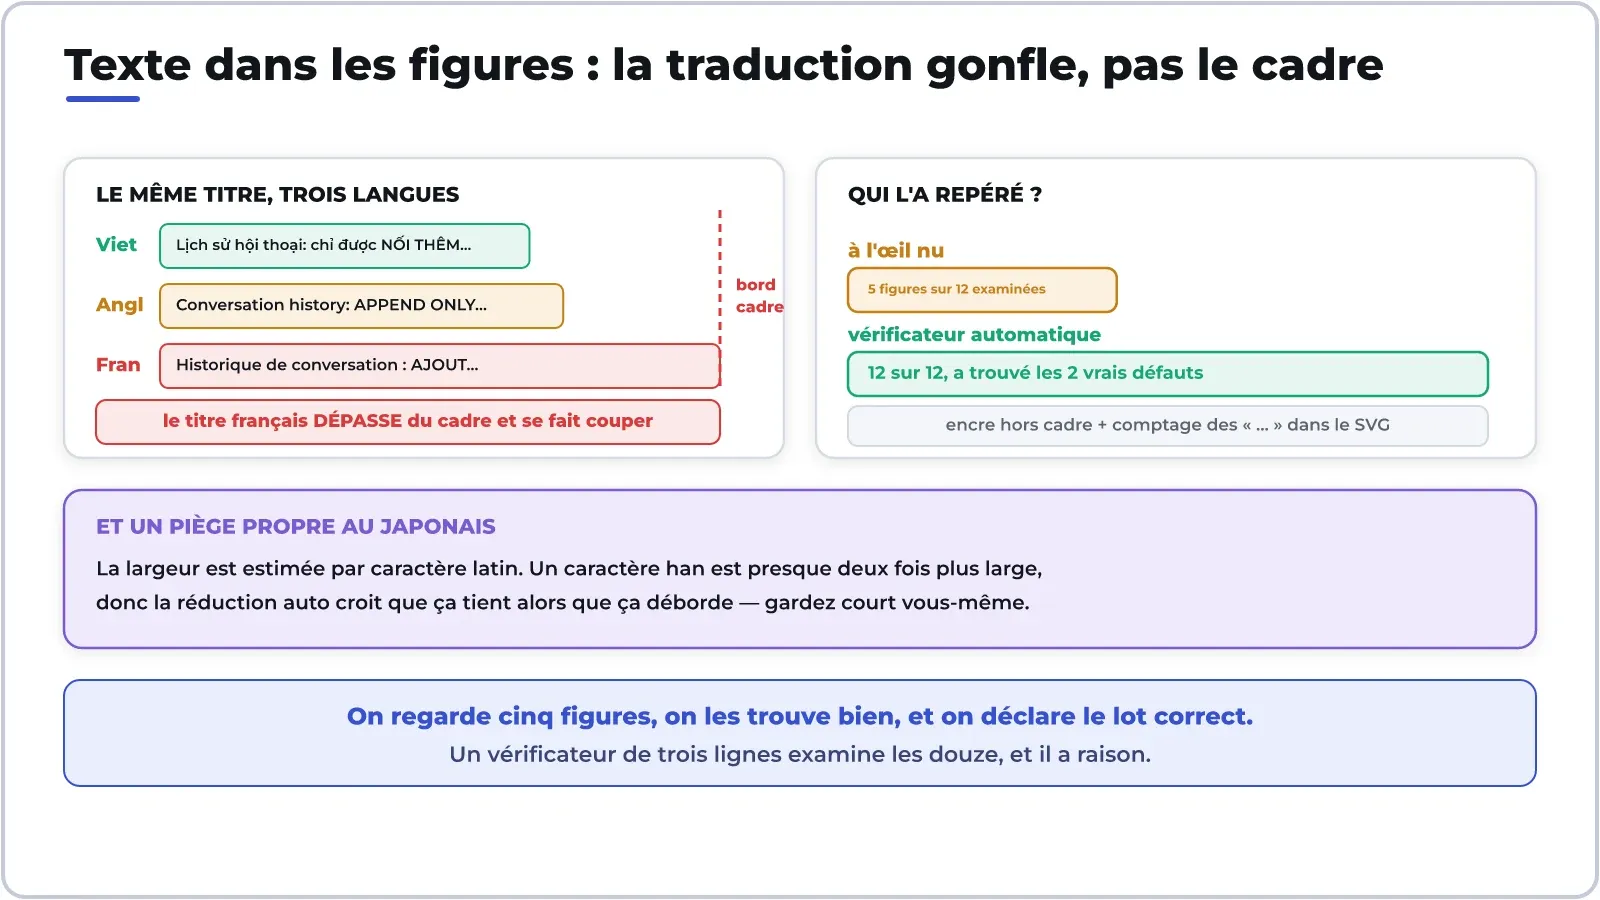
D’après les schémas que je viens de réaliser : pour un même titre, la version anglaise est environ un dixième plus longue que la version vietnamienne, tandis que la version française est jusqu’à un tiers plus longue. Ce titre en français déborde du bord de l’image et est tronqué, alors que les versions vietnamienne et anglaise s’adaptent parfaitement.
Le caractère japonais présente quant à lui un piège inverse. Comme il comporte moins de caractères, toutes les fonctions d’estimation de la largeur en fonction du nombre de caractères considèrent que la chaîne est encore courte — alors qu’un caractère chinois est près de deux fois plus large qu’un caractère latin. La fonction d’ajustement de la taille des caractères ne s’applique donc pas, et le texte déborde du cadre sans que personne ne s’en aperçoive.
La solution comporte deux volets. Premièrement : faire en sorte que toutes les polices ajustent automatiquement la taille des caractères lorsqu’ils dépassent le cadre — une modification apportée au niveau de la bibliothèque commune profitera à l’ensemble du document. Deuxièmement, et c’est là le point essentiel : développer un système de vérification automatique.
Ma procédure de vérification se résumait à trois points : vérifier qu’aucun trait d’encre ne dépassait les contours du cadre, et compter si le fichier SVG comportait des « … » générés par la fonction de recadrage automatique. Résultat : j’ai examiné à l’œil nu 5 des 12 images, je les ai trouvées belles et j’avais l’intention de les publier. Le programme de vérification a analysé les 12 images et a détecté 2 images défectueuses que je n’avais pas repérées lors de mon examen visuel.
C'est la leçon que j'ai le plus retenue de toute cette expérience : on voit cinq images, on les trouve belles, puis on en conclut que toute la série est belle. Avec des documents multilingues, la langue que vous ne maîtrisez pas est justement celle que vous jugez le plus superficiellement.
Le coin économique : le vrai coût du mot « gratuit »
Trois choix, trois façons de négocier.
Avec un outil de traduction auto-hébergé, la traduction ne coûte rien. Mais cela consomme de la mémoire vive, prend du temps de compilation et — comme nous l’avons mesuré plus haut — se paie en termes de qualité : tous les noms propres doivent être vérifiés manuellement. Dans le cas d’un document technique regorgeant de noms de produits, cela représente davantage un travail de correction qu’un travail de traduction. C’est précisément le compromis évoqué dans l’article sur l’auto-hébergement des services de traduction, sauf que cette fois-ci, le prix à payer se mesure en temps de relecture.
La formule gratuite d’un service commercial offre généralement environ un million de caractères par mois. Cela peut sembler abstrait, alors je vais vous donner un exemple concret tiré de mon archive : un article d’environ 2 600 mots, traduit en trois langues, représente environ 40 000 caractères — ce qui signifie que l’on peut publier environ 25 articles par mois sans débourser un centime. Pour un blog personnel, c’est largement suffisant ; pour une équipe chargée de la documentation produit, ce quota serait épuisé en une semaine.
Les forfaits payants sont facturés au caractère, et c’est là que l’on se trompe le plus souvent. Ce qu’il faut comparer, ce n’est pas le prix au million de caractères, mais la somme du coût de la traduction et du temps consacré aux corrections. Un service plus cher sur la facture mais qui respecte les noms propres peut s’avérer nettement moins coûteux, car il élimine une étape de vérification manuelle. Le même principe de calcul s’applique aux coûts par tâche effectuée et non par appel — voir également l’article comparatif sur les forfaits de stockage dans le cloud pour découvrir ce même type de piège lié aux prix affichés.
Et il y a un atout que peu de gens prennent en compte : le dictionnaire de surécriture est un outil qui prend de la valeur avec le temps. Les 137 expressions d'aujourd'hui deviendront 200 dans quelques mois, et chacune d'entre elles sera réutilisée dans tous les articles suivants. C’est également le seul élément de tout le processus qui ne dépend pas du service que vous utilisez : si vous changez de fournisseur, le dictionnaire vous suit.
Si vous envisagez de créer vous-même votre propre système de traduction, les cinq questions à se poser avant d'installer un logiciel open source s'appliquent toujours — et la plus importante d'entre elles concerne les coûts de maintenance.
Prévisions
- Le dictionnaire personnalisable deviendra un élément incontournable, et non plus une fonctionnalité haut de gamme. Lorsque tous les services traduiront aussi bien le texte courant, ce qui permettra de distinguer la qualité, ce seront les termes propres à chaque organisation.
- La traduction du texte dans les images sera automatisée dès le départ. Aujourd’hui, tout le monde traduit d’abord le texte avant de se rendre compte qu’il y a des images ; tout outil capable de regrouper ces deux tâches — et d’ajuster automatiquement la taille du texte pour qu’il s’adapte au cadre — répondra à la majeure partie de la demande en documents multilingues.
- Un système de vérification automatique accompagnera le processus de traduction, à l’instar d’un correcteur orthographique. Non pas pour évaluer la qualité de la traduction, mais pour détecter les erreurs mécaniques : débordements de cadre, coupures, chaînes non traduites.
- Les outils de traduction auto-hébergés ont toujours leur place, mais dans un autre contexte. Là où les données ne doivent pas quitter l’ordinateur — dossiers médicaux, contrats —, une qualité moindre reste un compromis acceptable. En revanche, pour les documents publics, les raisons de les utiliser s’amenuisent progressivement.
- Mais l’étape de la relecture humaine ne disparaîtra pas pour autant. Plus la traduction automatique est fluide, plus les erreurs sont difficiles à repérer : une phrase dont le sens est erroné mais dont la grammaire est correcte est bien plus dangereuse qu’une phrase bancale. Il faut toujours qu’une personne maîtrisant la langue en question relise le texte — et les outils de vérification automatiques ne font que leur éviter de devoir examiner ce que la machine a déjà repéré.
Thảo luận